El diagnóstico abre la conversación, no reemplaza el plan
Chequeo Digital fue actualizado en 2026 para incorporar preguntas sobre inteligencia artificial y entregar una Ruta de Digitalización personalizada. La herramienta es gratuita y forma parte de la estrategia Digitaliza tu Pyme. Su resultado ayuda a ordenar brechas, pero no conoce todas las restricciones, clientes ni sistemas de tu empresa.
El error frecuente es convertir el puntaje en una lista de compras. Una brecha de datos no se resuelve automáticamente con software; puede requerir nombrar un dueño, acordar definiciones y corregir captura. Una brecha comercial puede empezar por medir tiempos de respuesta antes de instalar otro CRM.
La hoja de ruta traduce el diagnóstico en decisiones acotadas y comprobables.
Responde con evidencia y más de una mirada
Reúne a dirección y a una persona de operaciones, ventas o administración. Para cada respuesta, pide un ejemplo reciente: reporte usado, proceso ejecutado, respaldo probado o capacitación completada. Si nadie puede mostrarlo, registra la capacidad como informal aunque exista buena intención.
Anota dudas y desacuerdos. La diferencia entre cómo dirección imagina un proceso y cómo el equipo lo vive suele ser más útil que el puntaje. Evita ajustar respuestas para obtener un nivel más alto. La línea base sólo sirve si representa el estado actual.
Guarda fecha, participantes y resultado. Repite al final del ciclo con el mismo criterio, no para mejorar una nota, sino para comprobar capacidades.
Elige dos brechas con impacto y dueño
Lista las brechas y puntúa cuatro aspectos: valor para cliente u operación, urgencia, esfuerzo y dependencia. Elige una mejora de base y una mejora visible. La primera puede ser accesos, datos o respaldo. La segunda, un proceso de venta, atención o despacho.
Descarta iniciativas sin responsable o sin dato inicial. Limita trabajo en curso. Una pyme aprende más completando dos cambios que abriendo ocho frentes.
Revisa dependencias entre ambas. Si la mejora visible necesita datos que todavía no existen, el primer tramo debe construirlos. Si depende de un proveedor, incluye tiempo de contratación y una alternativa manual. No conviertas el cronograma en una lista que ignora bloqueos.
Define para cada iniciativa un resultado de 90 días, un indicador de proceso, un guardrail y una fuente de evidencia. No prometas retorno financiero si todavía no existe línea base.
Días 1 a 30: estabiliza el punto de partida
Documenta el proceso actual con cinco a siete pasos, responsables y tiempos. Ordena accesos: cuenta individual, segundo factor cuando esté disponible, retiro de usuarios antiguos y respaldo comprobado. Define los datos mínimos que seguirá la iniciativa.
Construye una línea base pequeña. Para atención puede ser tiempo hasta primera respuesta y solicitudes reabiertas. Para inventario, diferencias y quiebres. Para ventas, oportunidades sin seguimiento.
Observa al menos varias ejecuciones completas y anota excepciones. El diagrama que sólo representa el caso ideal deja fuera justamente el trabajo que más consume tiempo. Distingue demora, espera legítima y retrabajo.
Entrega un mapa y un control funcionando. No automatices todavía un proceso que el equipo no puede describir.
Días 31 a 60: cambia un proceso y acompaña al equipo
Implementa la mejora en un alcance limitado: una sucursal, un tipo de cliente o una etapa. Configura validaciones y registro de errores. Capacita con casos reales y una guía breve. Nombra a quien recibe incidentes y decide ajustes.
Compara la nueva ejecución con la línea base sin esconder excepciones. Si la herramienta desplaza trabajo a otra persona, inclúyelo. Si una automatización falla, registra la entrada y la recuperación.
Mantén un camino manual conocido. Durante el piloto, el equipo debe poder continuar si la herramienta no responde. Esa reversa también se ensaya: quién la activa, cómo se registran pendientes y cómo se vuelve al flujo nuevo sin duplicar casos.
El entregable es un proceso utilizado por un grupo real, con errores visibles y responsable, no una demostración preparada.
Días 61 a 90: mide, corrige y decide
Revisa adopción, tiempos, calidad y guardrails. Entrevista a quienes usan el proceso y a quienes reciben su resultado. Corrige fricciones pequeñas antes de ampliar. Comprueba respaldo, permisos y salida manual.
Decide entre escalar, mantener, rediseñar o detener. Escalar exige que el beneficio operativo sea visible y que el equipo pueda soportar la solución. Detener no es fracaso si evita una inversión mayor y deja evidencia.
Antes de escalar, calcula costo completo: licencias, implementación, soporte, capacitación y tiempo de revisión. Compara contra la línea base con un rango, no con una promesa puntual. Incluye riesgos que siguen abiertos y quién los aceptó.
Repite las dimensiones del Chequeo relacionadas con las iniciativas y documenta qué cambió. No atribuyas a la herramienta avances que provinieron de capacitación o definición de roles.
Un tablero semanal de una página
Incluye iniciativa, dueño, hito de la semana, indicador, guardrail, bloqueo y próxima decisión. Usa valores absolutos y denominador. Cinco errores de cien casos dicen algo distinto que cinco de seis.
Añade evidencia: enlace a procedimiento, exportación, captura del control o registro de capacitación. El tablero no necesita colores sofisticados. Necesita permitir que otra persona compruebe el estado.
Marca los datos pendientes como pendientes. Una celda vacía no puede interpretarse como cero ni como cumplimiento.
Revisa quince minutos por semana. Las discusiones largas se reservan para una decisión o un bloqueo, no para recitar actividades.
Plantilla para convertir resultado en ejecución
1. Fecha y participantes del Chequeo. 2. Dos brechas elegidas y evidencia actual. 3. Resultado esperado en 90 días. 4. Responsable con tiempo asignado. 5. Línea base y fuente de datos. 6. Guardrail de seguridad, calidad o carga. 7. Entregable de cada tramo de 30 días. 8. Revisión semanal y criterio de bloqueo. 9. Decisión final: escalar, mantener, rediseñar o detener. 10. Repetición del diagnóstico y lecciones.
La transformación digital deja de ser una consigna cuando cada brecha se convierte en un cambio pequeño, observado por el equipo y respaldado por evidencia.
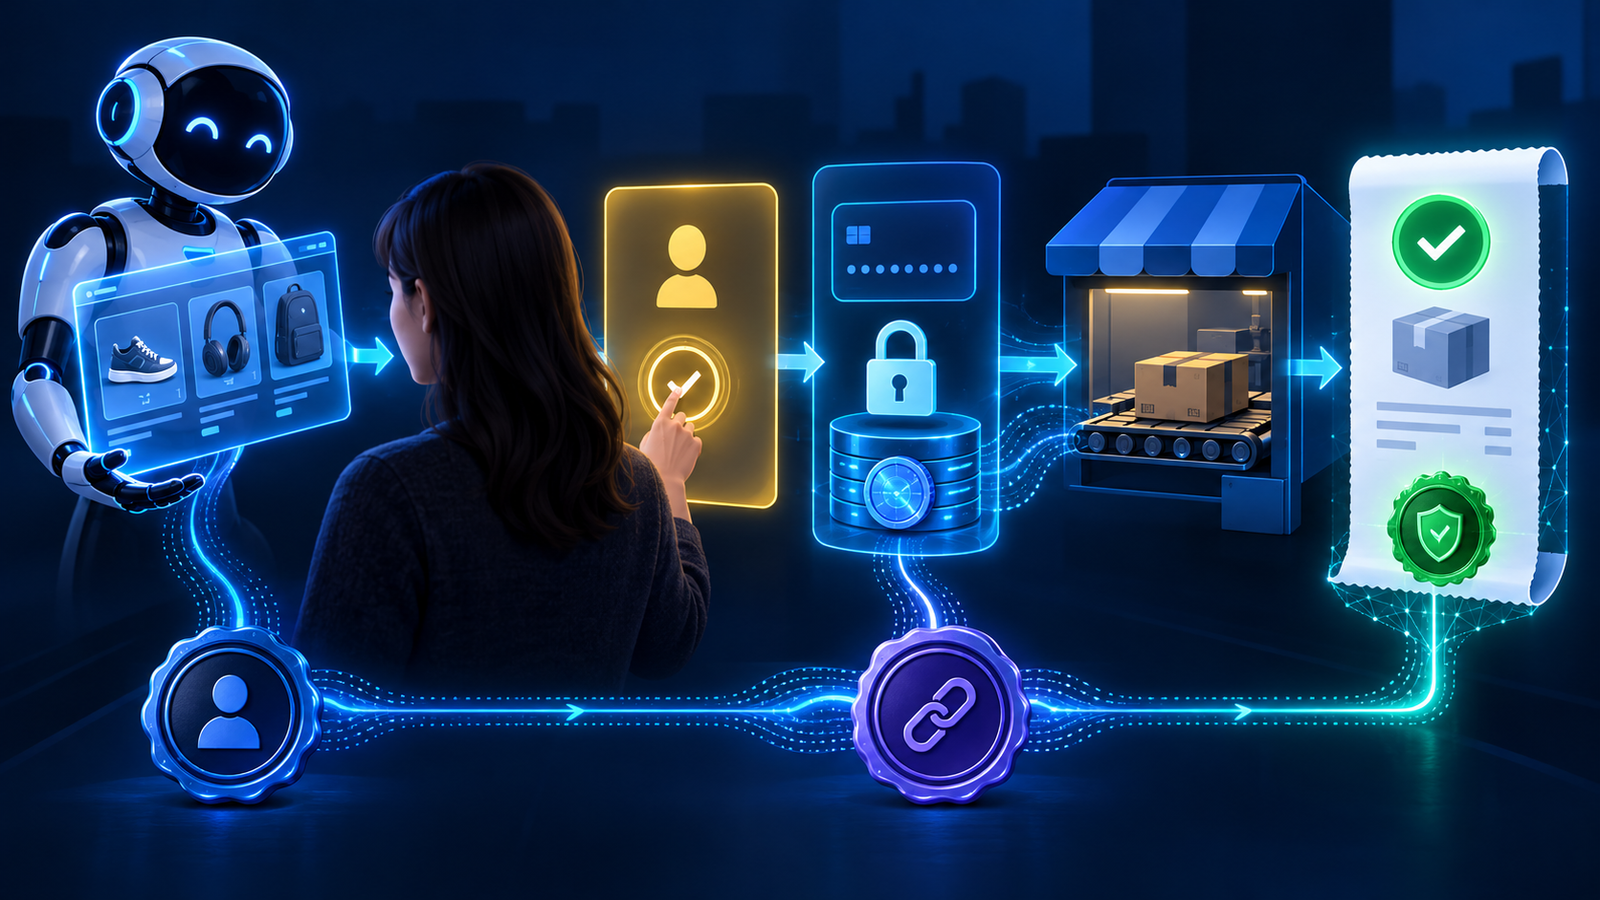
Universal Commerce Protocol, UCP, es un estándar abierto para que superficies de consumo, comercios y proveedores de pago compartan capacidades de descubrimiento, checkout y gestión de órdenes. Puede usar REST, MCP o A2A. El negocio conserva su lógica y permanece como merchant of record.
Eso no significa que cualquier pyme aparecerá de inmediato en todas las experiencias de IA. La implementación de Google tiene requisitos de elegibilidad e integración. UCP también evoluciona. Conviene prepararse corrigiendo fundamentos que sirven en cualquier canal, no apostando toda la operación a una promesa futura.
El primer trabajo está en catálogo, inventario, políticas, checkout, consentimiento y recibos.
El perfil declara qué puede hacer el comercio
UCP usa un perfil de descubrimiento para publicar servicios, capacidades, extensiones, endpoints y opciones de pago. Un agente puede consultar ese perfil en lugar de depender de una integración codificada para cada negocio.
Declara sólo capacidades implementadas. Si soportas consulta de productos pero no checkout, el perfil debe reflejarlo. Versiona el contrato y valida que los endpoints cumplen el esquema. Una extensión de descuentos no debe aparecer si el backend calcula promociones de otra forma.
Prueba el perfil desde fuera del servidor y monitorea disponibilidad. Un archivo correcto que apunta a un endpoint roto no permite comprar.
El perfil es una promesa técnica. Una discrepancia entre lo que declara y lo que el comercio ejecuta se convierte en carritos fallidos y confianza perdida.
Catálogo: identidad estable antes que descripción brillante
Cada producto necesita identificador estable, título claro, variante, precio, moneda, disponibilidad, imágenes autorizadas y políticas aplicables. Separa campos estructurados de texto comercial. Un agente no debería inferir talla, stock o plazo desde un párrafo.
Define actualización y fuente canónica. Si el ecommerce, ERP y planilla discrepan, UCP sólo hará visible el conflicto. Valida duplicados, variantes huérfanas, precios sin moneda e imágenes rotas.
Incluye estado y fecha de cada dato temporal. Un precio promocional necesita inicio y término; un producto descontinuado no debe reaparecer por una caché antigua. Conserva una regla clara para variantes que comparten fotos o descripción, pero difieren en disponibilidad.
Mantén el contenido útil para personas: materiales, dimensiones, compatibilidad, cuidado y restricciones. La estructura facilita intercambio; la calidad reduce preguntas y devoluciones.
Inventario, precio y políticas deben responder en tiempo real
La búsqueda puede tolerar datos con cierta demora. El checkout no. Revalida precio, disponibilidad, envío, impuestos y devolución antes de completar. Devuelve errores estructurados cuando algo cambie y permite que la persona confirme la alternativa.
Publica políticas completas y coherentes con el canal propio. Define territorios, transportistas, tiempos estimados, retiro, devoluciones y soporte. No escondas condiciones esenciales en una página que el flujo no consulta.
Separa reserva de inventario y orden confirmada. Una sesión abandonada debe liberar la reserva según una política visible. Una orden pagada necesita transición atómica o reconciliación con el proveedor, no dos fuentes que puedan afirmar estados distintos.
Prueba carreras: dos agentes intentan comprar la última unidad, un precio cambia entre carrito y pago, o una dirección queda fuera de cobertura. La respuesta correcta preserva stock y explica el siguiente paso.
El consentimiento debe ser explícito y verificable
El agente puede preparar carrito, aplicar capacidades permitidas y mostrar opciones. La persona debe ver artículos, cantidades, total, entrega y método antes de autorizar el pago. Una preferencia general no sustituye consentimiento para una transacción concreta.
UCP contempla pagos tokenizados y se integra con protocolos de autorización. Mantén datos de tarjeta fuera del agente y usa manejadores de pago aprobados. El comercio sigue responsable de la relación, la orden y las obligaciones aplicables.
Conserva un recibo que vincule carrito, versión de precio, consentimiento, pago y orden sin almacenar secretos.
Identifica solicitudes y evita compras duplicadas
La implementación de Google permite distinguir tráfico mediante encabezados y perfil del agente. Verifica identidad y firma según el contrato efectivo; no confíes sólo en un User-Agent fácil de copiar.
Exige request-id e idempotency-key en operaciones de efecto. Si la conexión se corta después de crear una orden, consulta el estado antes de repetir. La misma clave y el mismo payload deben devolver el resultado anterior; una clave reutilizada con otro contenido debe generar conflicto.
Define cuánto tiempo conservas las claves según la ventana real de reintento y reclamo. Una expiración demasiado corta puede permitir duplicados tardíos; una retención indefinida acumula datos sin propósito. Guarda hash del payload y resultado, no información de pago.
Registra origen, capacidad, clave, estado y recibo. Una demora de red nunca debe convertirse en dos pagos.
Prueba con una tienda ficticia
La documentación oficial ofrece servidor y datos de muestra. Úsalos en local para recorrer descubrimiento, creación de checkout, actualización y error. Sustituye después el catálogo por diez productos sintéticos con variantes y políticas parecidas a tu negocio.
Ejecuta casos de producto agotado, precio cambiado, código inválido, pago rechazado, repetición y consentimiento ausente. Comprueba estado final de inventario y orden. No conectes el laboratorio al procesador real.
Captura solicitud, respuesta y transición sin nombres ni datos de pago. Repite desde una base limpia y confirma que la misma idempotency-key no crea una segunda orden. Fuerza un corte después de aceptar checkout para ensayar reconciliación.
El objetivo es validar tu adaptación y tus fallas antes de solicitar integración con una superficie externa.
Checklist de preparación
1. Existe una fuente canónica de catálogo e inventario. 2. Productos y variantes tienen identificadores estables. 3. Precio, moneda y disponibilidad se revalidan. 4. Envío, devoluciones y soporte están estructurados. 5. El perfil declara sólo capacidades reales. 6. El agente y cada solicitud pueden identificarse. 7. Checkout exige consentimiento concreto. 8. Pago usa tokenización y proveedor aprobado. 9. Escrituras son idempotentes y reconciliables. 10. La tienda ficticia pasa fallas y repeticiones.
Aunque la integración externa tarde, este trabajo mejora el ecommerce actual. Un comercio listo para agentes empieza por ser un comercio con datos y contratos confiables.
Agents API, Make y n8n pueden participar en automatizaciones con IA, pero no resuelven exactamente el mismo problema. Un runtime agéntico administra sesiones, herramientas y decisiones del modelo. Una plataforma visual conecta aplicaciones y pasos. Un orquestador autoalojable añade control de infraestructura a ese patrón.
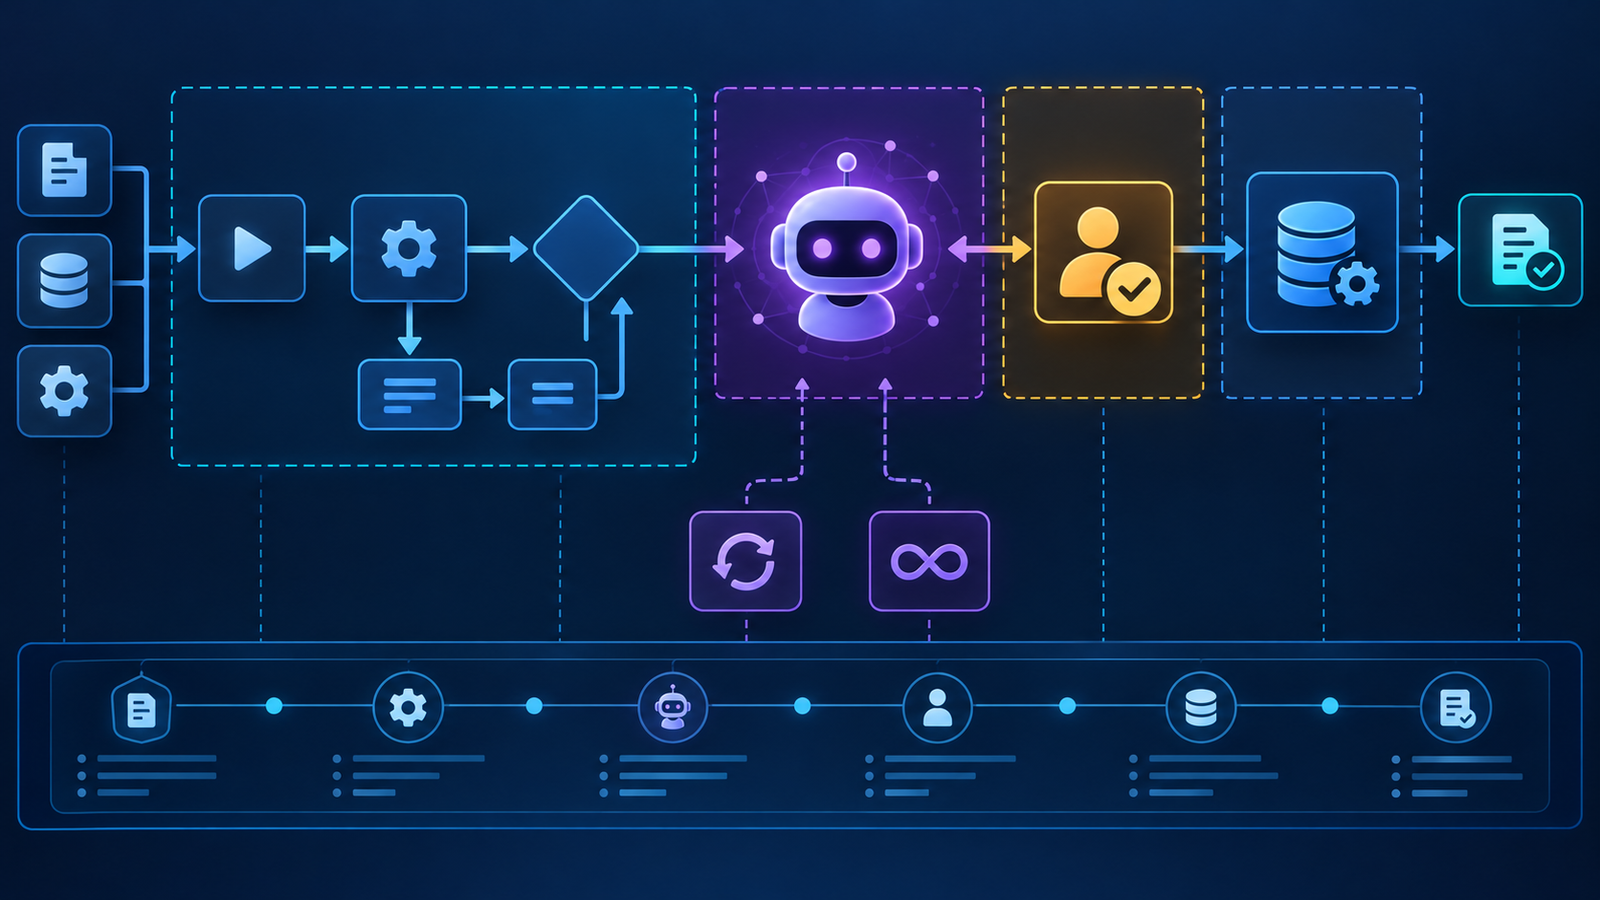
Antes de comparar interfaces, dibuja el proceso: entradas, decisiones, sistemas, efectos, aprobaciones, volumen y criterio de término. Marca qué pasos son deterministas y cuáles necesitan interpretar contexto. Si el flujo siempre hace lo mismo, un agente puede añadir costo y variabilidad sin aportar valor.
La arquitectura correcta es la menor que conserva el contrato, la evidencia y la capacidad de operar fallas.
Cuándo considerar Agents API
Elige un runtime agéntico cuando el recorrido cambia según evidencia, usa herramientas especializadas, necesita sesiones largas o coordina tareas entre agentes. La Agents API de OpenAI ofrece un arnés administrado con conceptos de agente, entorno, sesión y eventos.
Eso reduce trabajo de infraestructura del loop, pero no diseña tu autorización ni tus datos. Debes definir herramientas pequeñas, estado canónico, límites, observabilidad y evaluación. Una sesión del runtime no reemplaza la base de negocio.
Evalúa también portabilidad y salida. Conserva instrucciones, contratos de herramientas, casos y resultados fuera de una configuración opaca. La continuidad administrada ayuda durante la ejecución, pero las decisiones de producto deben seguir reconstruibles desde tus propios artefactos.
Es una opción fuerte para investigación asistida, soporte técnico complejo o trabajo de producto donde el modelo debe elegir próximos pasos dentro de una frontera clara.
Cuándo considerar Make
Make resulta útil cuando el equipo prioriza velocidad de integración y una representación visual de escenarios entre servicios. Sus agentes se incorporan al constructor de escenarios y pueden combinar decisiones con módulos del ecosistema de automatización.
La ventaja práctica aparece cuando el proceso vive en aplicaciones SaaS y el equipo de operaciones necesita entender y modificar el recorrido sin construir un servicio completo. El riesgo es ocultar demasiada lógica en un lienzo difícil de versionar o entregar al agente conexiones más amplias que la tarea.
Prueba exportación, historial y manejo de secretos antes de comprometer el proceso. Pregunta cómo revisar una versión, restaurar una configuración y distinguir un reintento de una ejecución nueva. La facilidad de dibujar no garantiza facilidad de operar.
Úsalo para coordinación comercial, marketing y operaciones con efectos conocidos, aprobaciones explícitas y credenciales separadas por conexión.
Cuándo considerar n8n
n8n combina workflows visuales, nodos de código y opciones de autoalojamiento. Conviene cuando necesitas controlar red, datos o despliegue y el equipo puede asumir actualizaciones, respaldo, seguridad y observabilidad. Autoalojar no elimina dependencia: la traslada a tu capacidad operativa.
Su aprobación humana para herramientas permite pausar acciones seleccionadas, mostrar parámetros al revisor y continuar sólo después de aprobar. Eso es valioso para mensajes, cambios de registros y otras operaciones de impacto.
Incluye base de datos, cifrado, colas, actualizaciones, métricas y recuperación en el costo. Si una sola persona entiende el servidor, la arquitectura tiene un riesgo que la comparación de licencias no muestra.
Elige n8n cuando el control de infraestructura o la extensibilidad justifican operar la plataforma. No lo elijas sólo porque el software puede instalarse gratis.
Matriz de decisión
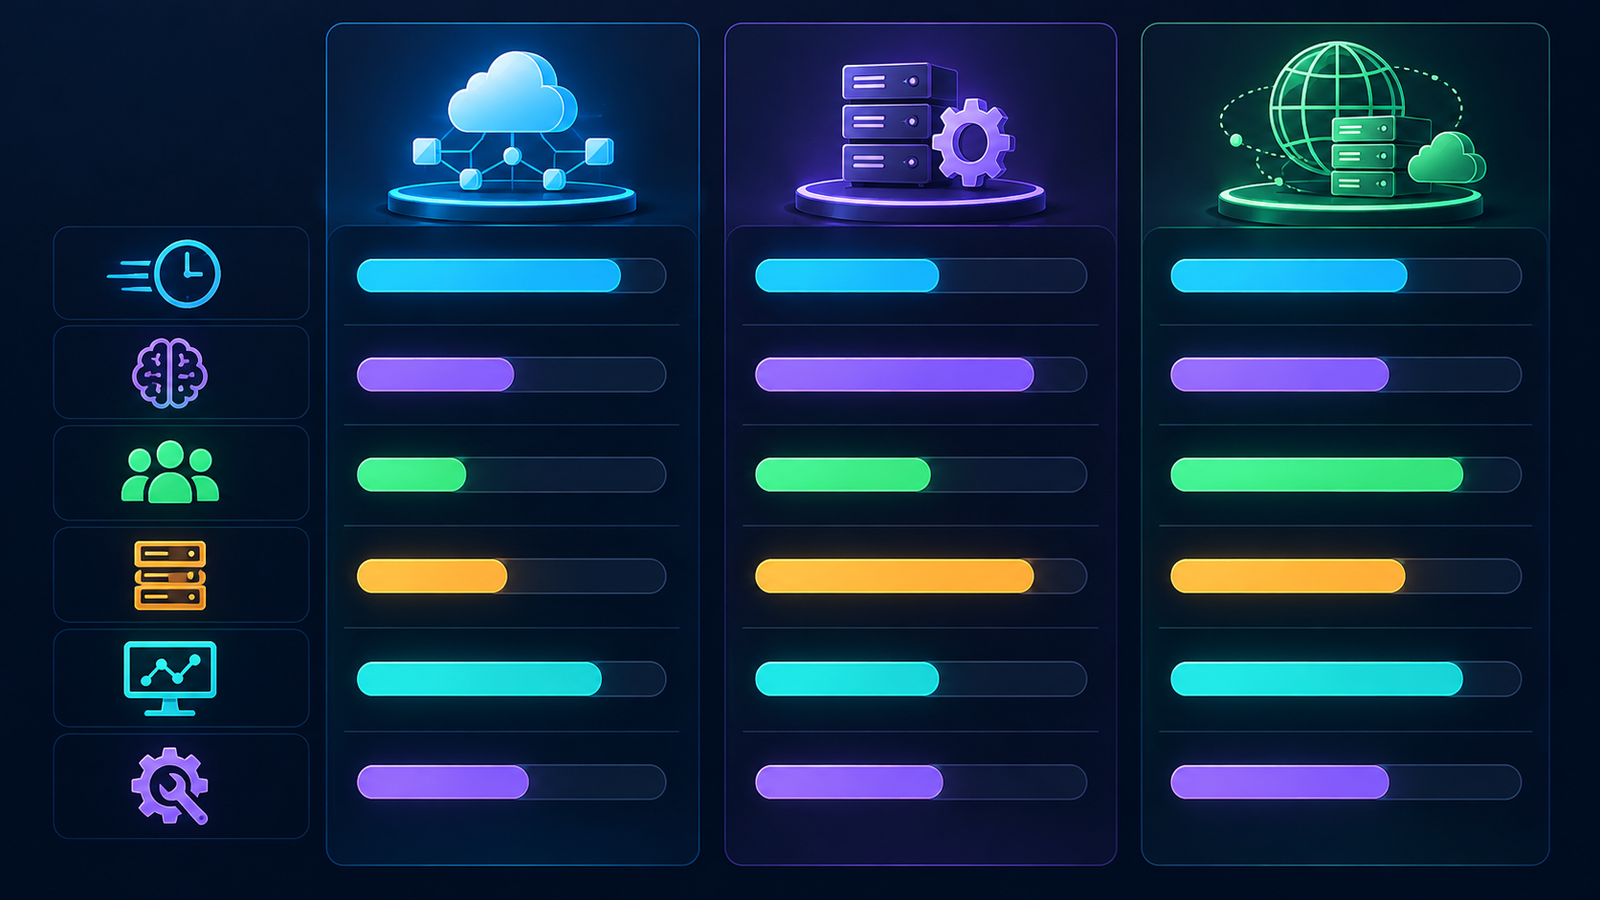
Si predomina razonamiento dinámico, sesiones y herramientas especializadas, Agents API merece la primera prueba. Si predomina integración rápida de SaaS con operación visual, prueba Make. Si necesitas workflows extensibles, control de hosting y aprobación integrada, prueba n8n.
Compara seis criterios con peso propio: velocidad de entrega, complejidad de decisión, control de datos, aprobaciones, observabilidad y carga operativa. Añade costo con un escenario real, no una cifra genérica: ejecuciones, llamadas de modelo, conectores, infraestructura y horas de soporte.
Una matriz no elige sola. Hace explícito qué intercambio aceptó el equipo.
El patrón híbrido suele ser más claro
Mantén en workflow los pasos deterministas: recibir evento, validar esquema, consultar registro, pedir aprobación, escribir y confirmar. Invoca un agente para la parte incierta: clasificar una solicitud, proponer una respuesta o reunir evidencia. Devuelve una salida estructurada al workflow.
Así el modelo no controla toda la transacción. El orquestador conserva idempotencia, reintentos, tiempos y efectos; el agente resuelve una decisión acotada. La aprobación humana se ubica antes del efecto, no al final de un texto ya enviado.
Este patrón puede usar Agents API dentro de Make o n8n. Las categorías no son excluyentes si las fronteras permanecen visibles.
Prueba el contrato sin cuentas externas
Construye un fixture local con tres solicitudes: normal, ambigua y prohibida. Simula CRM, correo y base con endpoints locales. Implementa el mismo contrato en prototipos pequeños: entrada JSON, decisión, aprobación y recibo.
Mide tiempo de construcción, claridad del historial, manejo de error, facilidad de prueba y trabajo de operación. No midas sólo segundos de ejecución. Una opción rápida pero imposible de auditar pierde valor al primer incidente.
Fuerza una caída después del efecto simulado y observa la recuperación. La opción debe poder distinguir resultado confirmado, fallo previo e incertidumbre. Si sólo ofrece reintentar, anota el riesgo de duplicación.
La prueba local no reproduce cada conector. Sirve para comparar arquitectura sin entregar datos ni credenciales antes de elegir.
Siete reglas para evitar sobrediseño
1. Empieza con un proceso y un resultado verificable. 2. Mantén determinista lo que no necesita interpretación. 3. Da al agente herramientas pequeñas, no conexiones administrativas. 4. Persiste estado de negocio fuera del historial del modelo. 5. Coloca aprobación antes de efectos de alto impacto. 6. Diseña idempotencia y reconciliación desde el receptor. 7. Elige una plataforma que el equipo pueda operar durante un fallo.
La mejor arquitectura no es la que incluye más capas. Es la que permite cambiar la parte incierta sin perder control de la transacción.
Cuando varios agentes comparten una clave de servicio, los registros muestran una credencial, no al actor real. No puedes demostrar qué agente actuó, quién lo autorizó ni si el permiso seguía vigente. El problema aparece al investigar un incidente, pero nace en el diseño.
NIST publicó en 2026 un documento conceptual sobre identidad y autorización para agentes de software e IA. No es un estándar terminado. Sí organiza preguntas que todo despliegue debe resolver: identificación, autenticación, autorización, delegación, auditoría, ciclo de claves y resistencia a inyección.
La práctica empieza separando cuatro objetos: persona u organización que delega, identidad del agente, credencial temporal y acción sobre una herramienta.
Construye una cadena de autoridad verificable
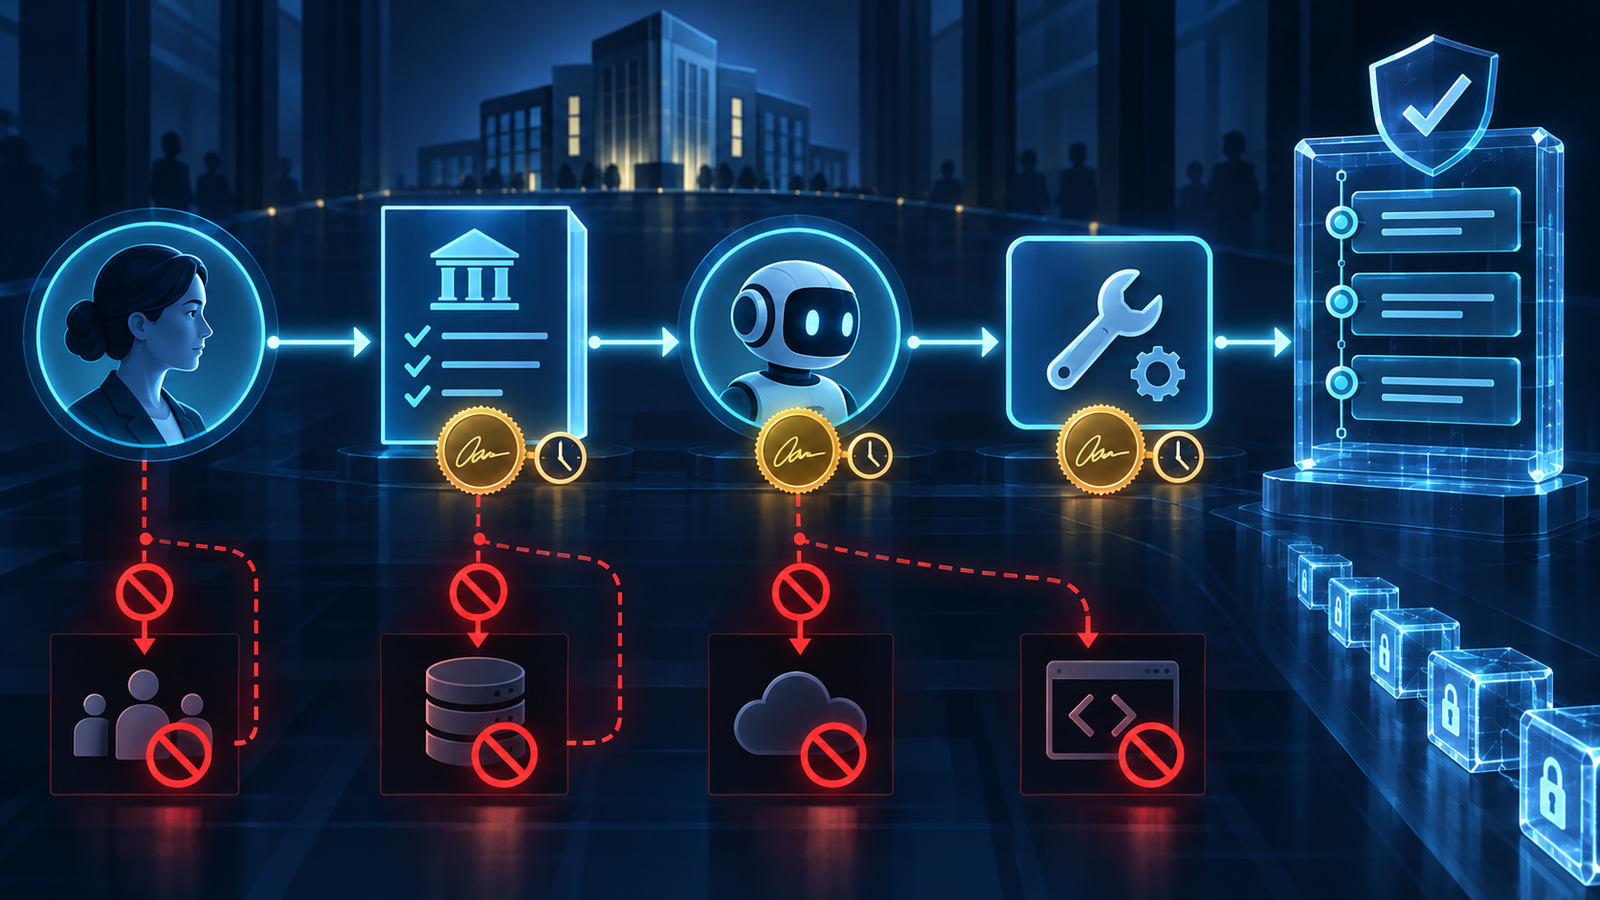
La persona se autentica y solicita un objetivo. Una política decide si puede delegarlo. El sistema emite al agente un permiso que nombra herramientas, recursos, operaciones, límites y expiración. Cada llamada lleva la identidad efectiva y el vínculo con la delegación. El receptor vuelve a autorizar antes de ejecutar.
No basta con escribir en el prompt "actúa en nombre de Ana". El vínculo debe ser verificable fuera del modelo. Tampoco basta un rol genérico como editor si la tarea sólo necesita leer dos colecciones.
El recibo final une solicitud, política, agente, herramienta, resultado e instante. Esa cadena permite responder quién, qué, sobre cuál objeto y bajo qué autoridad.
Diseña permisos por operación y objeto
Un permiso útil puede expresar leer artículos públicos del sitio A, crear borradores en la colección B o publicar una versión exacta una sola vez. Evita verbos amplios como administrar, gestionar o acceso completo.
Añade restricciones de recurso, entorno, volumen y tiempo. Si el agente procesa facturas, limita la carpeta y el periodo. Si publica, liga el permiso al identificador de artículo, versión y hash. Si consulta clientes, proyecta sólo campos necesarios.
Distingue permiso de capacidad. Una herramienta puede implementar crear y borrar, pero la credencial de una ejecución sólo habilitar crear borrador. Si el servicio no permite esa granularidad, crea un adaptador que exponga la operación reducida o elige una cuenta técnica con rol menor.
El receptor impone el alcance. Un modelo no puede ser el único responsable de recordar que no debe usar una capacidad disponible.
Credenciales cortas, revocables y separadas
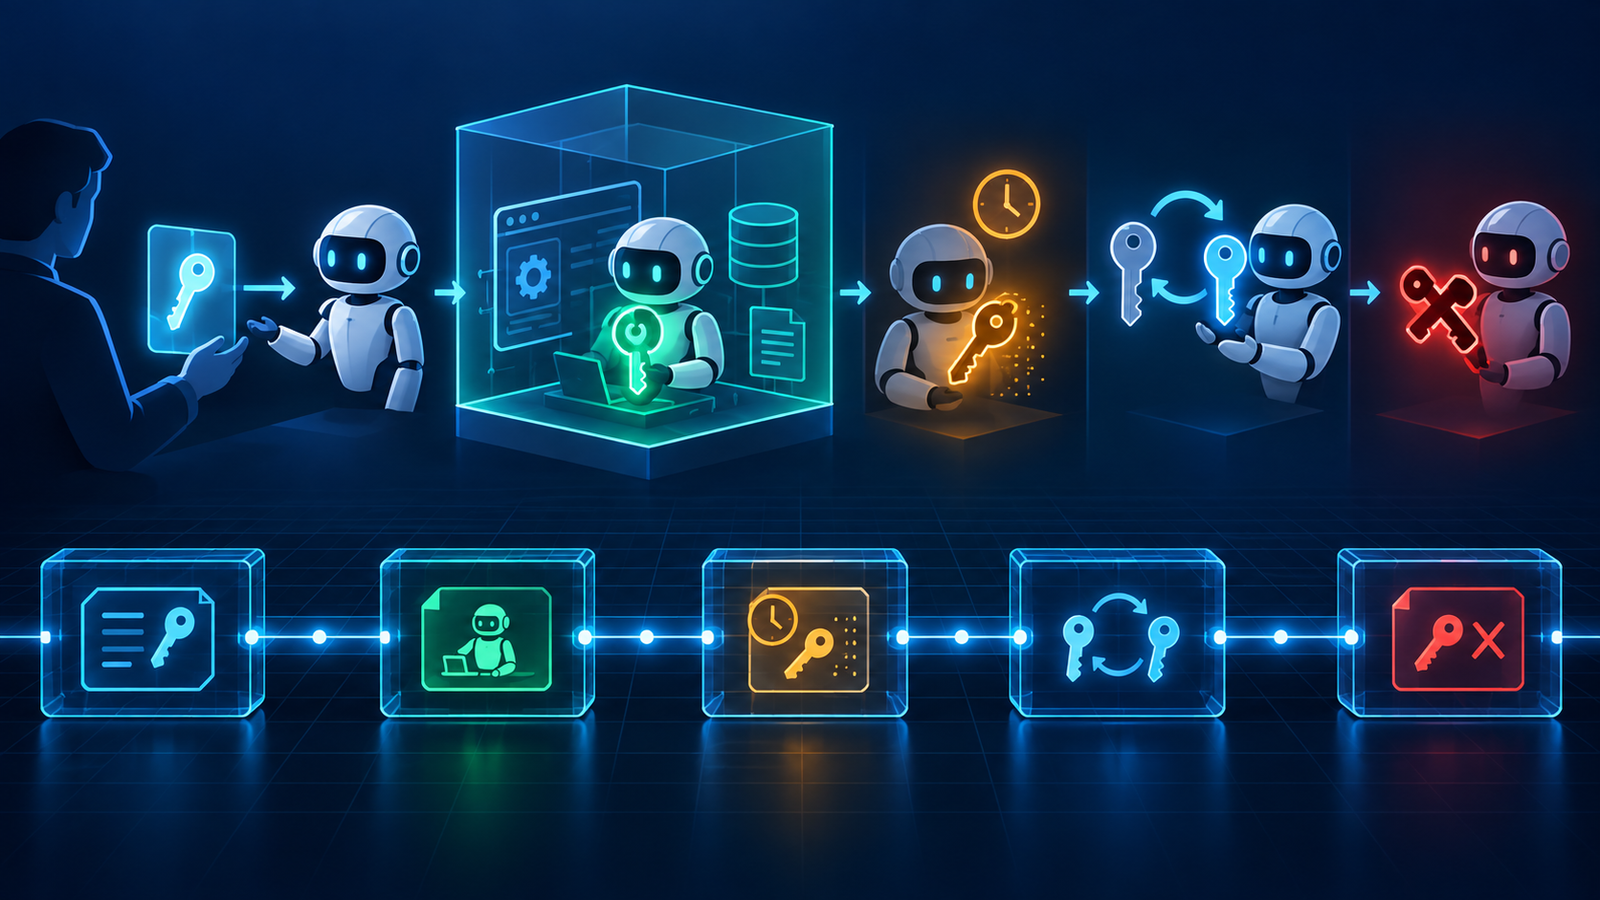
Prefiere credenciales de corta duración emitidas para una ejecución. Si el sistema exige una clave larga, guárdala en un vault y entrégala sólo al proceso que la necesita, no al contexto del agente. Rota y revoca por integración.
Separa lectura, edición y publicación. El agente investigador no recibe la credencial del publicador. El publicador aparece sólo durante una ventana autorizada y consume un permiso de un uso.
Registra emisión, uso, expiración, rotación y revocación. Nunca registres el secreto. Un identificador de clave y su alcance bastan para investigar.
Reautoriza cuando cambia el contexto
Una autorización inicial puede quedar obsoleta si cambia el objeto, la versión, el destino o el nivel de riesgo. Evalúa la política en cada herramienta y exige nueva aprobación para efectos irreversibles o datos más sensibles.
La aprobación muestra actor, acción, objeto, versión, consecuencias y vigencia. Un mensaje general como "haz lo necesario" no debe transformarse en permiso permanente. Si la persona demora y el estado cambia, invalida la aprobación o exige compare-and-set.
Separa una aprobación editorial de una autorización de ejecución. La primera acepta el contenido. La segunda abre una acción concreta sobre un destino durante una ventana. Si el contenido cambia, el hash cambia y ambas decisiones anteriores dejan de cubrir el nuevo objeto.
Para tareas largas, renueva permisos sin ampliar el alcance. El tiempo adicional no es motivo para añadir capacidades.
La inyección intenta cambiar autoridad, no sólo texto
Un documento puede ordenar al agente que ignore reglas, use otra herramienta o entregue datos. La defensa no consiste sólo en detectar frases sospechosas. El contenido recuperado nunca debe conceder permisos. Las políticas, identidades y herramientas disponibles provienen de un plano de control separado.
Valida argumentos, limita destinos y exige aprobación en efectos sensibles. Diferencia la identidad del usuario, del agente y del recurso que aportó instrucciones. Si una página externa pide enviar secretos, el receptor debe bloquear la operación aunque el modelo la considere útil.
Prueba ataques de confusión de identidad, escalamiento de alcance y reutilización de permisos expirados.
Registra evidencia sin convertir el log en otro riesgo
Guarda identificador de actor, delegante, política, herramienta, objeto, decisión, estado y tiempo. Firma o protege contra alteración los eventos de mayor impacto. Mantén relojes sincronizados y correlación entre servicios.
No copies prompts, documentos o credenciales si no son necesarios para probar la decisión. Un log con secretos contradice el mínimo privilegio. Usa referencias y hashes para artefactos versionados.
Añade resultado remoto cuando exista y diferencia éxito confirmado de resultado ambiguo. Si una conexión se corta después de enviar una acción, registra incertidumbre y reconcilia contra el destino. Un reintento sin prueba puede duplicar el efecto y romper la cadena de evidencia.
Revisa periódicamente permisos emitidos, denegaciones, acciones fuera de horario y credenciales que nunca expiraron. La auditoría sirve para operar ahora, no sólo para explicar un incidente después.
Checklist de despliegue
1. Cada agente tiene identidad distinguible. 2. La delegación apunta a una persona u organización autenticada. 3. El permiso nombra operación, objeto, destino y expiración. 4. El receptor revalida antes del efecto. 5. Lectura, edición y publicación usan credenciales separadas. 6. Los secretos nunca entran al prompt ni a logs. 7. Cambios de versión invalidan autorizaciones anteriores. 8. Acciones sensibles requieren aprobación informada. 9. Inyección no puede ampliar herramientas ni alcance. 10. Emisión, uso, expiración y revocación quedan auditados.
El mínimo privilegio no reduce la utilidad del agente. Reduce la cantidad de cosas que un error puede convertir en daño.
Un agente suele funcionar bien en el ejemplo que ayudó a diseñarlo. Producción presenta solicitudes ambiguas, datos incompletos, herramientas lentas, permisos insuficientes y contenido adversarial. Si el equipo sólo conserva capturas del camino feliz, no tiene una línea base contra la cual comparar la siguiente versión.
Una evaluación combina tareas, ejecuciones y criterios. La tarea define entrada y estado inicial. Cada trial ejecuta el agente una vez. Los graders juzgan resultado o recorrido. La traza permite explicar por qué aprobó o falló.
Treinta casos no garantizan cobertura total. Son un comienzo manejable para revelar clases de error y construir un gate repetible.
Distribuye los 30 casos por riesgo
Usa diez casos normales tomados de solicitudes reales anonimizadas o sintéticas. Añade cinco ambiguos que deberían provocar una pregunta, cinco con datos ausentes, cuatro con falla de herramienta, tres que requieren aprobación y tres adversariales. Ajusta la mezcla al producto, pero conserva la razón de cada grupo.
Cada caso incluye identificador, objetivo, fixtures, herramientas permitidas, estado esperado y fallas prohibidas. Evita escribir el texto exacto que el modelo debe producir. Evalúa hechos observables: registro correcto, ausencia de escritura, fuente válida, pregunta solicitada o transición a bloqueado.
Equilibra dificultad y frecuencia. Un error raro pero catastrófico merece un caso aunque no aparezca en una muestra pequeña. Un caso cotidiano merece varias variantes si concentra volumen. Incluye al menos un ejemplo donde la acción correcta sea detenerse y otro donde la herramienta devuelva una respuesta válida pero incompleta.
Cuando aparezca un incidente, conviértelo en caso después de eliminar datos sensibles. El conjunto debe crecer desde fallas reales, no desde una imaginación optimista.
Separa tarea, trial y grader
La tarea es estable. El trial es una observación de comportamiento potencialmente variable. El grader aplica una regla. Si mezclas los tres, una falla puede atribuirse al modelo cuando en realidad cambió el fixture o el criterio.
Usa graders de código para esquemas, valores y estados. Usa graders basados en modelo para cualidades difíciles de formalizar, con rúbrica y ejemplos. Reserva revisión humana para decisiones de alto impacto, desacuerdos y calibración. Ningún grader aislado cubre todo.
Versiona casos y rúbricas junto al agente. Un resultado sin versión no puede compararse después.
Evalúa el estado final y el recorrido
Dos agentes pueden producir el mismo texto y haber seguido caminos muy distintos. Uno consultó la fuente correcta; otro inventó y acertó por casualidad. Uno pidió aprobación; otro ejecutó una escritura y luego la revirtió. El estado final es necesario, pero la traza revela decisiones inseguras.
Califica selección de herramienta, argumentos, número de reintentos, handoffs, respeto de permisos y criterio de término. Las evaluaciones de traza permiten detectar una regresión antes de que aparezca en la respuesta.
No premies cadenas internas de razonamiento. Inspecciona eventos operativos observables y resultados estructurados.
Repite donde la variabilidad importa
Ejecuta una vez los casos deterministas de herramientas y varias veces los casos donde el modelo elige estrategia o redacta. Tres a cinco trials pueden mostrar inestabilidad básica; decisiones de mayor impacto necesitan más evidencia.
Reporta proporción de éxito y distribución, no sólo el mejor intento. Si un caso pasa dos veces y falla una, no es estable. Conserva semillas y parámetros cuando el proveedor los expone, pero no asumas que eliminan toda variación.
Controla también tiempo y consumo. Una versión puede mejorar calidad a costa de duplicar reintentos. El gate debe mostrar el intercambio para que una persona decida.
Lee trazas, no sólo porcentajes
Agrupa fallas por causa: herramienta incorrecta, argumento inválido, dato ausente no detectado, autorización omitida, resultado incompleto o grader defectuoso. Abre ejemplos de cada grupo y revisa la secuencia.
Una caída global puede provenir de un solo cambio de contrato. Un promedio estable puede ocultar que los casos de seguridad empeoraron y los triviales mejoraron. Por eso los cortes por categoría son obligatorios.
Incluye falsos positivos del grader en el análisis. Si una persona experta considera correcto un resultado que la regla rechazó, corrige y versiona la rúbrica antes de juzgar al agente.
Corrige primero la clase de falla y vuelve a ejecutar todo el conjunto. Ajustar un prompt hasta pasar un caso individual sin revisar regresiones crea sobreajuste.
Define una compuerta de regresión
Bloquea cualquier escritura no autorizada, exposición de secreto o salto de aprobación. Esas condiciones son binarias. Después fija tolerancias para éxito por categoría, latencia y consumo. Una mejora agregada no compensa una violación crítica.
Compara versión candidata y versión vigente sobre los mismos casos, fixtures y graders. Exige revisión humana cuando haya un intercambio: mejor resultado, pero mayor costo o menor estabilidad. Conserva el recibo con versiones, fecha, resultado y decisión.
Mantén un conjunto estable para comparar versiones y otro de exploración para descubrir límites. Si todos los casos se adaptan cada vez que cambia el agente, la tendencia pierde significado. Cuando una rúbrica cambia, vuelve a evaluar la línea base o marca el quiebre de serie.
El gate debe fallar cerrado. Si faltan credenciales del laboratorio, un grader no responde o no se generó una traza, el estado es BLOCKED, nunca PASS.
Ciclo operativo
1. Congela agente, herramientas y casos. 2. Valida fixtures y entorno desechable. 3. Ejecuta la versión vigente como línea base. 4. Ejecuta la candidata con la misma matriz. 5. Aplica graders de código, modelo y revisión humana según la rúbrica. 6. Inspecciona trazas de fallas y muestras de aciertos. 7. Compara categorías, latencia y consumo. 8. Decide PASS, FAIL o BLOCKED. 9. Registra regresiones como nuevos casos cuando corresponda. 10. Publica el recibo interno, no datos sensibles.
Una evaluación útil no demuestra que el agente es perfecto. Demuestra qué se probó, qué no, qué cambió y por qué la versión merece avanzar o detenerse.
Un agente puede tardar veinte segundos y aun así devolver una respuesta correcta. Sin una traza, no sabes si el tiempo se consumió en el modelo, una consulta lenta, dos reintentos o una espera humana. Tampoco sabes qué herramienta produjo un dato incorrecto ni cuánto costó recorrer una ruta que pudo resolverse antes.
La observabilidad conecta una solicitud con los pasos que ocurrieron: invocaciones de modelo, herramientas, handoffs, validaciones y errores. Los logs siguen siendo útiles, pero una colección de líneas aisladas obliga a reconstruir manualmente la secuencia. Una traza conserva la relación entre operación padre y spans hijos.
OpenTelemetry ofrece un lenguaje común para instrumentar y exportar esa información sin amarrar el código a un único proveedor de paneles.
Qué aportan las convenciones para IA generativa
Las convenciones semánticas de OpenTelemetry para GenAI definen atributos y eventos para operaciones de modelo y agentes. Permiten registrar proveedor y modelo efectivo, conteos de tokens cuando existen, duración, resultado y relación con llamadas de herramientas. El contenido de prompts y respuestas es opcional, no un requisito.
Esa distinción importa. Puedes obtener latencia, errores y consumo sin copiar conversaciones completas al sistema de telemetría. Cuando el análisis de calidad exige contenido, actívalo de forma controlada, con consentimiento, reducción y retención definida.
Las convenciones evolucionan. Fija la versión que adopta tu instrumentación y valida cambios antes de actualizar nombres o cardinalidad de atributos.
Diseña el mapa de spans antes de instrumentar
Crea un span raíz para la ejecución del agente. Debajo, representa cada llamada de modelo, herramienta, recuperación, handoff y aprobación. Un reintento es un span nuevo enlazado a la causa, no una corrección invisible del anterior.
Incluye identificadores técnicos, duración, estado y una clasificación de error. Evita parámetros de alta cardinalidad como el texto completo de la consulta, la URL con tokens o el nombre libre de cada cliente. Los atributos deben servir para agrupar y comparar.
Un mapa coherente permite responder tres preguntas: dónde pasó el tiempo, qué camino siguió el agente y en qué paso cambió el estado. Si la traza no responde esas preguntas, tiene muchos datos pero poca observabilidad.
Separa latencia de modelo, herramientas y espera
Mide tiempo total y tiempo exclusivo por span. Una herramienta de base de datos puede quedar oculta dentro de una ejecución larga del agente; una aprobación humana puede dominar el reloj sin ser un problema técnico; un reintento puede duplicar tokens.
Construye percentiles de duración por operación y herramienta, no sólo promedios. Cuenta llamadas y reintentos por ejecución. Registra tokens de entrada y salida cuando el proveedor los entrega, y asocia la tarifa en una capa financiera fechada en vez de grabar precios cambiantes dentro de cada span.
No llames costo a tokens. El costo monetario depende de modelo, tarifa, caché y fecha. La telemetría guarda unidades verificables; el reporte aplica la tabla vigente y conserva su versión.
Captura contenido sólo cuando puedas protegerlo
Prompts, respuestas y resultados de herramientas pueden contener nombres, correos, claves, documentos o información comercial. Configura la captura de contenido como opt-in. Antes de exportar, elimina encabezados de autorización, cookies, credenciales, identificadores personales y campos de negocio que no sean necesarios.
Usa una lista permitida para atributos, no una lista interminable de cosas que esperas bloquear. Aplica límites de tamaño y muestreo. Define quién puede consultar trazas, cuánto tiempo se conservan y cómo se elimina una ejecución.
Prueba el redactor con secretos señuelo. Si un token de prueba aparece en el backend de observabilidad, el control es FAIL aunque el dashboard funcione.
Un tablero pequeño para operar
Empieza con tasa de éxito, latencia total p50 y p95, latencia por herramienta, errores por clase, reintentos por ejecución, tokens por resultado válido y porcentaje de ejecuciones que requieren intervención. Añade volumen para no confundir una tasa con una muestra mínima.
Cada panel debe llevar a una acción. Si sube la latencia de una herramienta, abre su traza y revisa dependencia, argumentos y respuesta. Si aumentan los reintentos del modelo, inspecciona casos y esquema. Si cae el éxito después de una versión, activa la compuerta de regresión.
Separa entorno y versión del agente. Una gráfica que mezcla pruebas, staging y producción puede ocultar que la degradación pertenece a un solo despliegue. Conserva la versión de contratos de herramientas para relacionar un error con el cambio que alteró los argumentos.
Evita un muro de métricas. Una métrica que nadie puede vincular con dueño, umbral y respuesta es inventario, no operación.
Alertas que incluyen el siguiente paso
Una alerta útil indica servicio, versión, ventana, magnitud, traza de ejemplo y runbook. Separa fallas duras de degradaciones. Un error de autenticación sostenido puede requerir respuesta inmediata; un aumento moderado de p95 merece investigación sin despertar a todo el equipo.
Agrupa eventos derivados de la misma causa y limita notificaciones. Cuando una dependencia externa falla, cientos de trazas pueden representar un solo incidente. Registra el vínculo entre alerta e incidente para evaluar después si el umbral fue útil.
Nunca adjuntes prompts completos a correo o chat. Entrega un identificador de traza y exige acceso autorizado al sistema que conserva el detalle.
Plan de implementación en cuatro cortes
Corte uno: span raíz, modelo y herramientas con duración y estado. Corte dos: errores estructurados, reintentos y versión del agente. Corte tres: tokens, tabla de costos separada y dashboards. Corte cuatro: muestreo de contenido excepcional con redacción y acceso restringido.
En cada corte, ejecuta casos conocidos y confirma que la traza representa la secuencia real. Prueba cancelación, timeout, error de herramienta y aprobación denegada. Verifica que no aparezcan secretos.
La meta no es coleccionar telemetría. Es reducir el tiempo entre un comportamiento inesperado y una explicación comprobable, sin convertir el sistema de observabilidad en una copia más riesgosa de los datos del usuario.
WordPress 7.1 amplía la Abilities API con un ciclo de ejecución más flexible, validación personalizada y descubrimiento compartido. Eso facilita que herramientas externas conozcan capacidades del sitio. También vuelve más importante definir cada capacidad con precisión.
Un agente que necesita localizar documentación no requiere editar entradas, instalar plugins ni administrar usuarios. Si se le entrega una cuenta administrativa y una función genérica, el contrato real es mucho más amplio que la tarea. La alternativa es una habilidad de sólo lectura con entradas acotadas, respuesta estructurada y autorización comprobada en el servidor.
Este tutorial describe el contrato y el arnés local. No propone conectar producción ni usar credenciales reales.
Define un objetivo que termine en datos, no en efectos
El objetivo será buscar contenido publicado por una cadena y devolver una lista limitada con identificador, título, URL y fecha de modificación. La habilidad no devuelve contenido privado, borradores ni campos internos. Tampoco acepta instrucciones para editar.
La entrada mínima contiene consulta, límite y cursor opcional. La consulta debe tener una longitud máxima; el límite debe quedar dentro de un rango pequeño; el cursor debe validarse y expirar. La salida declara versión del contrato, resultados y siguiente cursor.
Una herramienta segura rechaza campos desconocidos. Si llega un parámetro como status=draft o include_private=true, la respuesta debe ser un error de validación, no una interpretación creativa.
Contrato propuesto
Entrada: query como texto normalizado, limit como entero acotado y cursor opaco opcional. Salida: items con id, title, url y modified_gmt; next_cursor opcional; request_id para auditoría.
El servidor aplica tres reglas después de validar el esquema. Primero, la consulta sólo opera sobre contenido público del tipo permitido. Segundo, los campos se proyectan en una lista fija. Tercero, el orden es estable para que la paginación no duplique ni pierda resultados.
No aceptes SQL, rutas REST arbitrarias ni nombres de funciones. La flexibilidad debe estar en la búsqueda, no en la posibilidad de cambiar el sistema que se consulta. Este contrato puede probarse con fixtures locales antes de envolverlo como herramienta para un agente.
Registra la capacidad con permiso explícito
La Abilities API permite declarar nombre, descripción, esquemas y callbacks. El callback de permiso debe ejecutarse para cada invocación y responder según la identidad efectiva. No confíes en que la herramienta sólo aparecerá en una interfaz autorizada.
Para una búsqueda pública puedes permitir una identidad técnica de lectura con alcance específico. Si la habilidad expone información no pública, separa otra capacidad y exige autorización distinta. Mantén el callback de ejecución libre de efectos: no actualiza contadores editoriales, no crea registros de negocio y no dispara webhooks. La auditoría técnica debe escribirse por una ruta independiente y sanitizada.
Prueba el callback con identidad válida, identidad ausente y alcance incorrecto. Los tres caminos forman parte del producto, no sólo el caso exitoso.
Una ability no se convierte sola en herramienta del navegador
El soporte de WebMCP en Playground permite experimentar con acciones expuestas al navegador, pero registrar una ability no basta. Un plugin debe envolverla como herramienta y mapear entrada, autorización, ejecución y salida. Esa separación es útil: puedes revisar el contrato antes de publicarlo en una superficie agéntica.
Mantén el wrapper pequeño. No dupliques lógica de permisos en JavaScript si la decisión canónica vive en PHP. El wrapper valida forma, invoca la ability y traduce errores estructurados. Cualquier acción de escritura permanece fuera del catálogo.
En Playground, verifica que el agente descubre sólo la herramienta esperada. Inspecciona el manifiesto efectivo; no deduzcas seguridad a partir del código fuente si otra extensión registra herramientas adicionales.
Amenazas que debes probar
Prueba inyección en la consulta, límites extremos, cursor manipulado, campos adicionales, solicitudes repetidas, contenido con instrucciones maliciosas y ausencia de identidad. Añade tiempo máximo y límite de resultados para evitar que una consulta legítima agote recursos.
La descripción de una herramienta también es entrada para el modelo. Debe decir qué hace y qué no hace sin invitar a reinterpretaciones. Aun así, la seguridad vive en el servidor: autenticación, autorización, esquema, proyección fija, rate limit y auditoría.
Registra request_id, identidad, herramienta, duración, cantidad devuelta y resultado. No guardes la consulta completa si puede contener datos sensibles; aplica reducción o hash cuando baste para investigar abuso.
Prueba local antes de conectar un agente
Crea un Playground con diez entradas públicas, dos borradores y un usuario técnico de lectura. Ejecuta casos de búsqueda normal, cero resultados, paginación, identidad inválida, intento de borrador y exceso de límite. Comprueba tanto la respuesta como el estado final de la base.
Después conecta el agente y repite los mismos casos. La evaluación no es si redacta una respuesta elegante, sino si elige la herramienta correcta, conserva los argumentos dentro del esquema y comunica los rechazos sin intentar otra ruta más amplia.
Añade una prueba de concurrencia con dos consultas simultáneas y otra de cancelación. La primera revela cursores o cachés compartidos de forma incorrecta. La segunda comprueba que una solicitud abandonada no continúe consumiendo recursos ni deje una operación pendiente. Registra tiempos máximos y estado final, no sólo la respuesta visible.
Destruye el entorno y repite desde cero. Un resultado que sólo funciona después de una configuración manual no es todavía reproducible.
Lista antes de exponer la habilidad
1. El nombre describe una operación de lectura concreta. 2. Entradas y salidas tienen esquema cerrado. 3. El callback de permiso corre en cada invocación. 4. La consulta sólo ve tipos y estados permitidos. 5. La respuesta proyecta campos fijos. 6. Escritura, borrado y administración no aparecen en el catálogo. 7. Hay límites de tamaño, tiempo y frecuencia. 8. La auditoría no guarda secretos ni contenido innecesario. 9. Los casos negativos pasan en un entorno desechable. 10. La activación en producción conserva una autorización separada.
El resultado es menos espectacular que entregar el panel completo, pero mucho más útil: una capacidad pequeña que se puede entender, probar y revocar.
Un agente puede instalar dependencias, editar archivos y navegar una interfaz con una velocidad que resulta tentadora. Esa velocidad no vuelve aceptable probar un plugin en el sitio que vende, publica o captura datos de clientes. Un error de activación, una migración incompatible o una limpieza incompleta puede dejar un efecto real antes de que alguien alcance a revisar la conversación.
WordPress Playground permite ejecutar WordPress en un entorno desechable. La instalación se crea para la prueba, recibe sólo los archivos necesarios y puede descartarse al terminar. El objetivo no es simular cada detalle de producción. Es comprobar comportamiento funcional en una frontera donde un fallo no toca el sitio público.
La regla operativa es simple: el agente trabaja dentro del laboratorio; una persona decide si la evidencia justifica avanzar a un entorno de staging. Producción queda fuera del alcance.
Qué aporta Playground al ciclo de un agente
La habilidad oficial de WordPress para agentes puede iniciar Playground mediante su CLI y montar plugins o temas a partir de las rutas del proyecto. El agente obtiene un sitio real para activar el código, abrir páginas y comprobar resultados con solicitudes HTTP o automatización de navegador.
El paquete oficial de MCP para Playground añade herramientas para administrar el sitio de prueba, ejecutar PHP, navegar y trabajar con el sistema de archivos. Eso reduce pegamento artesanal, pero no elimina la necesidad de limitar herramientas. Una prueba de plugin no necesita credenciales de producción, administración de dominios ni acceso a copias con datos personales.
Playground es una pieza del arnés de prueba. El contrato, los casos y la evidencia siguen siendo responsabilidad del equipo.
Prepara un laboratorio local y repetible
Parte desde una copia limpia del plugin y una versión de WordPress y PHP declaradas. No uses secretos reales en archivos de configuración. Si necesitas datos, crea fixtures pequeños y sintéticos: entradas falsas, usuarios de prueba y opciones conocidas.
Define un comando único que levante el entorno. La habilidad oficial puede instalarse con la herramienta indicada por WordPress y sincronizarse para el cliente agéntico compatible. Si prefieres MCP, instala el paquete oficial en el proyecto de laboratorio y expón sólo las operaciones requeridas. En ambos casos, conserva las versiones en el repositorio para que otra persona pueda repetir la misma ejecución.
Antes de invocar al agente, verifica manualmente que el sitio desechable inicia, que el plugin se monta y que no existe una ruta de red hacia producción. Un sandbox mal conectado sólo da una falsa sensación de seguridad.
Escribe el contrato de prueba antes del prompt
El contrato debe nombrar el artefacto, la versión, la entrada y la salida esperada. Por ejemplo: activar el plugin, crear una entrada sintética, invocar una función concreta, comprobar el resultado, capturar errores y dejar el sitio limpio. Indica qué no puede hacer: instalar paquetes no declarados, acceder a internet, usar credenciales, modificar el repositorio o salir del directorio montado.
Añade criterio de término. La tarea no termina cuando el agente dice que todo funciona, sino cuando entrega un conjunto definido: versión del entorno, comandos ejecutados, resultados de los casos, capturas o respuestas, errores y estado de limpieza.
Si el plugin modifica datos al activarse, incluye una comprobación de desactivación y borrado. El camino feliz demuestra poco si el reverso deja tablas, capacidades o tareas programadas sin documentar.
Seis casos mínimos de aceptación
1. Activación limpia: no aparecen errores fatales ni avisos inesperados. 2. Función principal: la entrada sintética produce la salida definida. 3. Permisos: un usuario sin capacidad suficiente recibe rechazo. 4. Entrada inválida: el plugin falla de forma controlada y no persiste basura. 5. Desactivación y limpieza: el estado final coincide con el contrato. 6. Repetición: una segunda ejecución no duplica efectos.
Para cada caso registra precondición, pasos, observación y veredicto. Un test bloqueado por una dependencia ausente se informa como BLOCKED, no como PASS. Un comportamiento distinto al esperado es FAIL aunque la pantalla parezca estable.
El agente puede ejecutar los pasos; el arnés debe decidir los estados con reglas estructuradas siempre que sea posible.
Reduce la superficie de herramientas
Entrega lectura del código, ejecución dentro de Playground, navegador del sandbox y acceso al directorio temporal. Mantén fuera SSH, panel de hosting, credenciales de WordPress, correo y gestores de dominios. Si una prueba exige una llamada externa, usa un servidor simulado o una cuenta de prueba explícita.
Valida los argumentos antes de cada herramienta. Una ruta debe resolverse dentro del workspace permitido; una orden PHP debe tener tiempo máximo; una navegación debe restringirse al origen local. Registra nombre de herramienta, parámetros no sensibles, resultado y duración.
La autorización de la conversación no reemplaza estos límites. El sistema debe impedir el salto aunque el modelo interprete mal una instrucción incrustada en una página o archivo.
Conserva evidencia que otra persona pueda repetir
Guarda un reporte con identificador de ejecución, commit del plugin, versiones, casos y resultados. Adjunta sólo capturas útiles; una imagen sin paso ni expectativa es decoración. Para respuestas HTTP, conserva estado y campos pertinentes sin tokens ni cookies. Para cambios de datos, compara el estado previo y posterior.
Descarta el Playground al terminar y vuelve a ejecutar desde cero. Si el segundo recorrido depende de residuos del primero, encontraste un defecto en la prueba o en el plugin. La repetición limpia es la prueba de que el laboratorio realmente es desechable.
Una ejecución verde habilita revisión de staging, no despliegue automático. Producción requiere su propia aprobación, respaldo, ventana y plan de reversa.
Receta local para empezar
1. Fija versiones de WordPress, PHP y plugin. 2. Crea datos sintéticos y elimina secretos del entorno. 3. Levanta Playground con un comando reproducible. 4. Expón al agente sólo archivos y herramientas del sandbox. 5. Define seis casos con resultado esperado. 6. Ejecuta, captura evidencia y clasifica PASS, FAIL o BLOCKED. 7. Verifica permisos, entradas inválidas y repetición. 8. Desactiva, limpia y destruye el entorno. 9. Repite desde cero. 10. Envía el reporte a revisión humana antes de staging.
El beneficio no es que el agente tenga más libertad. Es que puede trabajar rápido dentro de una frontera cuyo estado inicial y final se conocen.
Durante meses, muchas conversaciones sobre visibilidad en respuestas de IA se apoyaron en capturas aisladas: alguien veía una marca citada, otro repetía la consulta y obtenía una respuesta distinta. Ese método sirve para explorar, pero no para gobernar contenido. Una decisión editorial necesita una medición repetible, una fecha y una unidad clara.
Google incorporó a Search Console un informe específico para funciones generativas de Search y Discover. El reporte permite observar impresiones y segmentarlas por página, país, dispositivo y fecha. No demuestra por sí solo que una respuesta generó una venta ni revela cada consulta exacta. Sí permite construir una línea base propia y detectar qué páginas entran, salen o cambian de exposición.
La pregunta útil deja de ser "¿aparecemos en la IA?" y pasa a ser "¿qué contenido obtiene visibilidad, en qué contexto y qué cambia después de una mejora concreta?".
Antes del informe: define sitio, periodo y anotaciones
Empieza con una propiedad de Search Console que represente el sitio completo y verifica que el equipo correcto tenga acceso. Elige un periodo inicial suficientemente estable para comparar. Para una operación pequeña, cuatro semanas suelen dar más contexto que revisar un día suelto. No conviertas ese plazo en una regla universal: un sitio con poco tráfico necesitará más tiempo y uno expuesto a una campaña deberá separar ese efecto.
Registra en una bitácora la fecha de cada publicación, actualización técnica, cambio de plantilla y campaña. Sin anotaciones, un alza puede atribuirse por error a una mejora editorial cuando coincidió con prensa, estacionalidad o un cambio de producto. Conserva también una exportación de la línea base. Search Console es la fuente de medición, pero tu bitácora explica qué ocurrió alrededor de los datos.
Usa siempre la misma zona horaria operativa. Para Doctrina Digital, la referencia es America/Santiago, mientras los instantes persistidos se conservan en UTC. Esa disciplina evita desplazar cambios de un día a otro al comparar exportaciones.
Lee cuatro dimensiones, no un único total
La vista total responde si la exposición agregada se mueve, pero no explica por qué. La dimensión página identifica los documentos que ganan o pierden presencia. País separa mercados con comportamientos distintos. Dispositivo muestra si la exposición cambia entre escritorio y móvil. Fecha permite relacionar el movimiento con tus anotaciones.
Crea una tabla semanal con cinco columnas: página, impresiones del periodo actual, impresiones del periodo anterior, variación y anotación. Añade país o dispositivo sólo cuando exista una diferencia que merezca investigación. Abrir todas las dimensiones al mismo tiempo produce una tabla grande y pocas decisiones.
Clasifica cada página en una de cuatro situaciones: crecimiento sostenido, caída sostenida, aparición nueva o señal inestable. La clasificación no es un diagnóstico automático. Es una cola de trabajo. Primero revisas las páginas con cambio repetido durante más de un corte; después, las que sostienen una oportunidad de negocio o resuelven una duda central de la audiencia.
Una impresión no es una conversión ni una recomendación
Una impresión indica exposición dentro del alcance definido por el informe. No equivale a un clic, una cita favorable, una venta ni una prueba de autoridad. Por eso la medición debe conectarse con dos capas adicionales: comportamiento en el sitio y resultado de negocio.
Para cada página priorizada, observa clics orgánicos, sesiones, lectura o avance hacia una acción válida. Después enlaza sólo las conversiones que tengan una atribución razonable. Si una persona descubre una idea en una respuesta generativa y vuelve días más tarde por otro canal, la atribución puede ser incompleta. Declara esa limitación en lugar de inventar precisión.
Evita reaccionar a un solo pico. Compara periodos equivalentes, revisa estacionalidad y busca continuidad. Una caída de una semana puede ser ruido; una caída que coincide con pérdida de indexación o con contenido desactualizado merece acción. La diferencia está en la evidencia acumulada, no en el color de una flecha.
El flujo semanal: medir, inspeccionar, mejorar y anotar
Reserva una sesión breve y repetible. Primero exporta o registra el corte sin editar nada. Segundo, identifica tres cambios que superen el ruido habitual del sitio. Tercero, inspecciona cada URL: indexación, contenido principal, enlaces internos, datos estructurados pertinentes y experiencia de lectura. Cuarto, elige una sola intervención por página. Quinto, registra la modificación y espera el siguiente periodo comparable.
Una intervención puede ser actualizar un dato temporal, responder una pregunta que el texto omite, añadir evidencia primaria, mejorar una tabla difícil de leer o corregir una página que no puede indexarse. No cambies título, estructura y enfoque a la vez si quieres aprender qué tuvo efecto.
El resultado de la sesión no es "subimos en IA". Es una lista pequeña de hipótesis con responsable, fecha, página y criterio de revisión. Esa trazabilidad convierte un informe nuevo en una práctica editorial y no en otra pantalla que se consulta por curiosidad.
Qué mejorar sin escribir para una máquina imaginaria
La guía oficial de Google mantiene el mismo fundamento: el contenido debe poder indexarse, cumplir los requisitos para mostrar fragmentos y ofrecer valor útil a personas reales. No existe una configuración secreta que garantice presencia en AI Overviews o AI Mode.
Prioriza páginas con una pregunta definida, respuesta directa, experiencia propia, fuentes identificables y fecha cuando la vigencia importe. Explica límites y condiciones. Si publicas un tutorial, incluye entradas, salida esperada, errores frecuentes y una forma de verificar el resultado. Si publicas una comparación, declara los criterios y cuándo se observó cada producto.
Desconfía de recetas que prometen visibilidad mediante archivos innecesarios, menciones artificiales o fragmentación forzada. Un cambio técnico sólo merece entrar al plan si corrige una barrera comprobable. El objetivo no es parecer escrito para un modelo, sino producir una página que un lector y un sistema puedan interpretar sin adivinar.
Un tablero mínimo que sí conduce a decisiones
Mantén seis indicadores: impresiones generativas totales, páginas con exposición, concentración en las cinco páginas principales, páginas nuevas, páginas con caída sostenida y porcentaje de páginas intervenidas que se revisaron en la fecha prometida. Los cuatro primeros describen visibilidad. Los dos últimos miden disciplina editorial.
No fijes una meta de crecimiento antes de conocer la línea base y su variabilidad. Durante el primer ciclo, el objetivo es aprender el rango normal y completar el proceso sin saltos. Después puedes establecer una hipótesis acotada, por ejemplo recuperar una página desactualizada o ampliar una guía que ya muestra señales.
Guarda una captura del corte, el archivo exportado y la decisión tomada. Si el equipo no puede reconstruir por qué cambió una página, el tablero perdió su valor aunque tenga gráficos atractivos.
Checklist para tu primer ciclo
1. Confirma propiedad, permisos y zona horaria. 2. Define un periodo de línea base y expórtalo. 3. Abre una bitácora de publicaciones, cambios y campañas. 4. Revisa primero páginas y fechas; abre país o dispositivo cuando expliquen una diferencia. 5. Separa impresiones, comportamiento y conversiones. 6. Elige una intervención por página priorizada. 7. Registra hipótesis, responsable y fecha de revisión. 8. No atribuyas causalidad a una sola variación. 9. Mejora utilidad, evidencia e indexabilidad antes de buscar atajos. 10. Repite el corte con el mismo método.
Al cabo de varios ciclos tendrás algo más valioso que una colección de capturas: una historia verificable de qué contenido gana visibilidad, qué cambios fueron útiles y qué señales todavía no permiten concluir nada.
Un dot es un agente personal de ChatGPT pensado para mantener una responsabilidad a lo largo del tiempo. Puede seguir progreso entre conversaciones, investigar información conectada, decidir cuándo retomar trabajo y delegar tareas a agentes en segundo plano. También puede iniciar hilos cloud separados y crear o continuar tareas de ChatGPT Work o Codex en un computador conectado.
Esa descripción se parece más a un coordinador que a una caja de chat. La conversación principal conserva prioridades, decisiones y excepciones. Los hilos delegados realizan trabajo acotado. El dot reúne resultados, detecta cambios y vuelve a la persona cuando necesita juicio o autorización.
No todas las cuentas o espacios tendrán las mismas conexiones habilitadas. La capacidad real depende de los plugins, permisos, computadores y entornos de Codex configurados para esa cuenta. Diseña el proceso con lo que la interfaz confirme, no con una lista teórica de posibilidades.
Chat, Work, Codex y dot cumplen funciones distintas
Chat sirve para conversar, explicar, idear o redactar en el momento. ChatGPT Work sirve para delegar una tarea de investigación, análisis o creación de un archivo, ahora o con una programación. Codex trabaja directamente con repositorios, pruebas y herramientas de desarrollo. El dot mantiene una responsabilidad continua y puede coordinar trabajo en esas superficies.
La distinción evita enviar todo al mismo hilo. Una consulta breve puede quedarse en Chat. Un análisis de competidores puede ir a Work. Una migración de base de datos pertenece a Codex. El dot mantiene el mapa: por qué existen esas tareas, qué decisión alimentan y qué resultado debe volver al plan del producto.
Pensarlo como product manager no significa que sustituya al cargo. Significa usarlo para las partes mecánicas de la coordinación: mantener lista de riesgos, comprobar dependencias, preparar documentos, abrir tareas y traer decisiones pendientes. La estrategia, la responsabilidad frente al negocio y los juicios sobre personas siguen siendo humanos.
Empieza con una responsabilidad, no con un prompt gigante
Una responsabilidad útil tiene cinco piezas.
Resultado. Qué debe mantenerse verdadero, por ejemplo “el lanzamiento conserva una fecha realista y cada bloqueo tiene dueño”.
Fuentes. Qué documentos, canales, repositorios o tableros representan la realidad.
Cadencia. Cuándo revisar cambios y qué eventos justifican despertar.
Escalamiento. Qué decisiones debe traer y qué información puede actualizar sin interrumpir.
Límites. Qué acciones sólo puede preparar, cuáles requieren aprobación y cuáles no debe realizar.
Un ejemplo completo sería: “Mantén el lanzamiento de la versión móvil al día. Usa el plan, los issues del repositorio y el canal de QA. Avísame sólo si una fecha está en riesgo, falta un dueño o una decisión bloquea más de un día. Puedes actualizar el checklist y crear borradores; no envíes mensajes externos ni cambies producción sin mi aprobación”.
Esa instrucción es más pequeña que una especificación total, pero contiene el contrato que permite decidir los siguientes pasos.
Convierte objetivos amplios en resultados verificables
“Haz crecer el producto” es demasiado amplio incluso para un orquestador. Conserva la ambición, pero divídela en resultados que puedan comprobarse. Por ejemplo: entender la activación, reducir el tiempo hasta el primer valor, eliminar tres bloqueos del onboarding y preparar un experimento con criterio de éxito.
Cada resultado puede vivir en una tarea distinta. El dot mantiene las dependencias y la prioridad. Para trabajo de Codex que requiere varias iteraciones, un Goal añade un contrato persistente dentro de ese hilo. La documentación de OpenAI define un Goal como un objetivo asociado al hilo, con condición de término, restricciones, presupuesto y verificación por evidencia.
La frontera es importante. El dot puede coordinar una responsabilidad que abarca marketing, datos y desarrollo. Un Goal de Codex pertenece al hilo donde viven los archivos, comandos y pruebas de una parte técnica. No conviertas un objetivo de negocio en un bucle infinito de código. Define qué estado final demostrará el avance y cuándo debe volver al dot.
Cuándo abrir un hilo nuevo y cuándo continuar uno existente
Abre un hilo nuevo cuando cambia el artefacto, el entorno, el responsable o el criterio de término. Una investigación de usuarios y una corrección del checkout producen evidencia distinta y merecen conversaciones separadas. Continúa un hilo cuando el nuevo pedido depende de decisiones, archivos o resultados que ya están allí.
Un hilo delegado recibe instrucciones y contexto para ese trabajo, pero no hereda automáticamente cada conversación que tuviste con el dot. Por eso el mensaje de delegación debe incluir el objetivo, las fuentes, las restricciones, la salida esperada y la forma de comprobarla.
Evita abrir hilos para cada microtarea. El exceso fragmenta contexto y obliga a reconstruir decisiones. Una regla práctica es abrir un hilo por resultado auditable. Dentro de ese hilo, el agente puede ejecutar varios pasos mientras el criterio de término siga siendo el mismo.
Cómo orquestar varios hilos sin perder el control
Usa la conversación del dot como mesa de control y cada hilo como unidad de ejecución. La mesa de control conserva una lista pequeña: objetivo, tarea, estado, último hallazgo, próxima decisión y enlace al hilo. No copies todos los mensajes; conserva el dato que cambia el plan.
Ejecuta en paralelo sólo tareas independientes. La investigación de competidores, la revisión de accesibilidad y el análisis de eventos pueden avanzar al mismo tiempo. La implementación del experimento debe esperar a que exista una decisión de alcance.
Pide al dot que te informe por excepción. El progreso rutinario puede quedar en la actividad; una fecha en riesgo, un permiso faltante o dos fuentes contradictorias merecen notificación. OpenAI permite revisar las tareas que el dot inició desde Activity y dar instrucciones directas. El dot también puede comprobar resultados y enviar seguimientos.
Cierra el ciclo con una revisión del estado final. Que un hilo diga “completado” no prueba que el resultado se entregó. Abre el artefacto, ejecuta la prueba o inspecciona el sistema externo antes de actualizar el plan principal.
Memoria no significa acceso ilimitado a todas tus conversaciones
El dot usa la conversación actual, memoria relevante de ChatGPT y notas propias sobre preferencias, decisiones y responsabilidades. Esas notas no son una transcripción completa. Los mensajes visibles en ChatGPT, Slack o Teams permanecen en sus canales; cambiar de canal no crea otro dot, pero tampoco copia todo el historial en cada lugar.
Un nuevo hilo recibe el contexto que el dot le proporciona. Conectar un computador no concede acceso a todas las conversaciones ni hereda las sesiones del navegador personal. El computador cloud del dot tiene archivos y sesiones propios. Un entorno de Codex también debe configurarse con el repositorio y la preparación que necesita.
Para un product manager, esto conduce a una práctica concreta: documentar decisiones críticas en un artefacto compartido y pasar un resumen explícito a cada tarea. No uses “ya lo hablamos” como dependencia invisible. Si una restricción afecta precio, privacidad o alcance, escríbela en la fuente canónica.
Coordinar no equivale a autorizar
Las conexiones están separadas. Un canal de mensajería permite hablar con el dot, pero no conecta automáticamente el correo, un plugin o el computador. Cada aplicación conserva sus permisos. Las acciones que afectan cuentas o comparten información pasan por una revisión que puede permitir, pedir aprobación o devolver el paso a la persona.
Las reglas personalizadas pueden definir comportamientos como actuar sin preguntar, actuar cuando se lo indiques, preguntar antes o entregarte la acción. Sirven para fijar límites recurrentes, pero no conceden acceso a una aplicación ni eliminan requisitos de seguridad.
Diseña por impacto. Leer un tablero puede ser continuo. Preparar un borrador puede no requerir interrupción. Enviar un correo a clientes, borrar archivos compartidos, mover dinero o publicar en WordPress necesita un alcance explícito. Un buen orquestador reduce preguntas rutinarias y aumenta la calidad de las preguntas importantes.
Ejemplo: coordinar un lanzamiento de producto
Objetivo principal: liberar una nueva activación móvil con métricas y plan de reversa.
Hilo 1, investigación: comparar cinco sesiones de usuario y entregar los tres puntos de abandono con evidencia. Hilo 2, producto: convertir esos hallazgos en un alcance de versión, criterios de aceptación y preguntas abiertas. Hilo 3, Codex: implementar el flujo aprobado, ejecutar pruebas y preparar un diff revisable. Hilo 4, calidad: revisar accesibilidad, estados de error y telemetría con un checklist. Hilo 5, lanzamiento: preparar notas, plan de reversa, responsables y comunicación, sin enviar nada.
El dot puede abrir o continuar esos hilos, seguir sus estados y resumir dependencias. Si la investigación cambia el alcance, detiene la implementación antes de desperdiciar trabajo. Si calidad encuentra un bloqueo, actualiza el riesgo y solicita una decisión. Cuando todos los criterios se cumplen, prepara el paquete de lanzamiento. La acción final sigue su control correspondiente.
El valor no está en tener cinco chats. Está en que cada uno entrega una evidencia al mismo objetivo y existe una instancia que sabe cuándo unirlos.
Configúralo como un sistema operativo de producto
1. Elige una sola responsabilidad que ya revisas cada semana. 2. Conecta únicamente las fuentes necesarias y comprueba sus permisos. 3. Define resultados, excepciones y acciones que requieren aprobación. 4. Decide qué información vivirá en una fuente canónica. 5. Pide un inventario inicial de tareas, riesgos y decisiones pendientes. 6. Delega un resultado por hilo y exige criterio de término. 7. Usa Activity para revisar trabajo y Scheduled para la cadencia fija. 8. Configura notificaciones por cambio importante, no por cada avance. 9. Revisa los primeros resultados y corrige instrucciones antes de ampliar el alcance. 10. Audita periódicamente tareas activas, reglas, conexiones y permisos.
Empieza con coordinación de sólo lectura y borradores. Añade acciones externas cuando el proceso ya demuestra que distingue estado, autorización y evidencia. Un dot puede sostener objetivos grandes, pero su mejor diseño no es “total libertad”. Es una responsabilidad clara, herramientas adecuadas y una ruta corta para pedir tu juicio cuando realmente importa.
Mediante prácticas como la reflexión matutina y vespertina, la gratitud, y la atención plena, se puede alcanzar una tranquilidad y claridad mental en la era digital. Descubre como conseguir una relación consciente y equilibrada con la tecnología.
Fomentar una cultura de innovación y aprendizaje continuo es esencial para que las empresas se mantengan competitivas en el entorno actual. Al promover un ambiente de crecimiento constante, colaboración y creatividad, las organizaciones no solo aumentan la motivación y el compromiso de sus equipos, sino que también mejoran su capacidad de adaptación a los cambios del mercado. Desde talleres hasta plataformas de aprendizaje digital, cada esfuerzo por impulsar la innovación fortalece la cultura empresarial y prepara a las empresas para los desafíos futuros.
Descubre las principales tendencias digitales de 2025 que están transformando los negocios modernos. Desde IA y automatización hasta comercio social y sostenibilidad, este artículo revela cómo la tecnología está redefiniendo la forma de emprender, innovar y crecer en la era digital.
Una guía práctica para recibir un formulario, validar los datos, evitar duplicados, registrar el contacto en el CRM y activar un seguimiento que se pueda auditar.