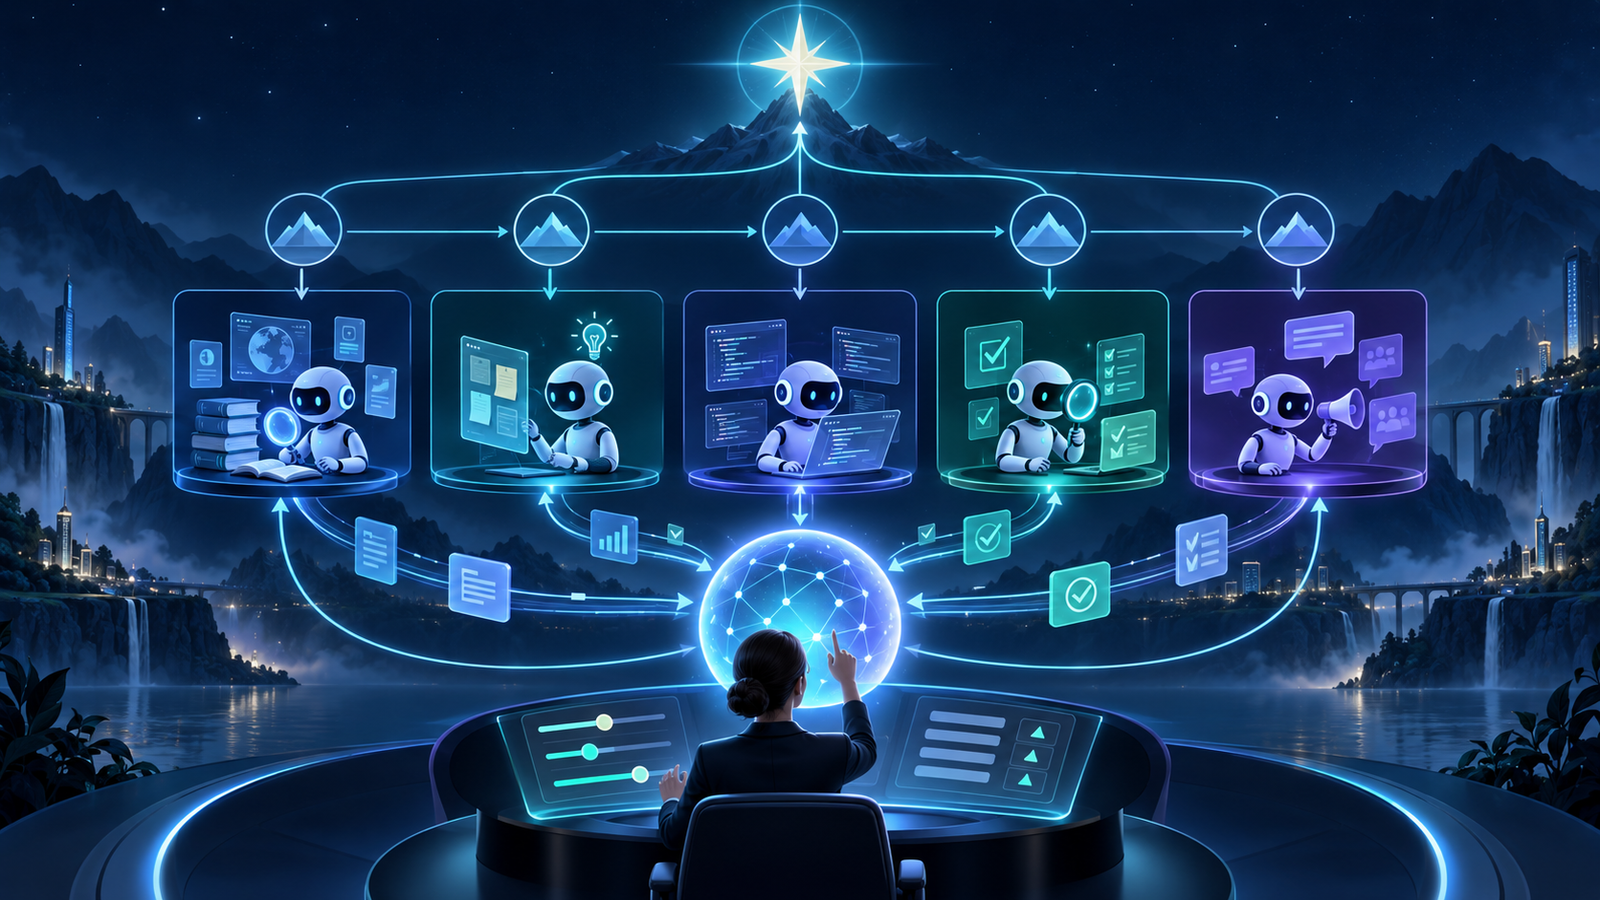
Un dot es un agente personal de ChatGPT pensado para mantener una responsabilidad a lo largo del tiempo. Puede seguir progreso entre conversaciones, investigar información conectada, decidir cuándo retomar trabajo y delegar tareas a agentes en segundo plano. También puede iniciar hilos cloud separados y crear o continuar tareas de ChatGPT Work o Codex en un computador conectado.
Esa descripción se parece más a un coordinador que a una caja de chat. La conversación principal conserva prioridades, decisiones y excepciones. Los hilos delegados realizan trabajo acotado. El dot reúne resultados, detecta cambios y vuelve a la persona cuando necesita juicio o autorización.
No todas las cuentas o espacios tendrán las mismas conexiones habilitadas. La capacidad real depende de los plugins, permisos, computadores y entornos de Codex configurados para esa cuenta. Diseña el proceso con lo que la interfaz confirme, no con una lista teórica de posibilidades.
Chat, Work, Codex y dot cumplen funciones distintas
Chat sirve para conversar, explicar, idear o redactar en el momento. ChatGPT Work sirve para delegar una tarea de investigación, análisis o creación de un archivo, ahora o con una programación. Codex trabaja directamente con repositorios, pruebas y herramientas de desarrollo. El dot mantiene una responsabilidad continua y puede coordinar trabajo en esas superficies.
La distinción evita enviar todo al mismo hilo. Una consulta breve puede quedarse en Chat. Un análisis de competidores puede ir a Work. Una migración de base de datos pertenece a Codex. El dot mantiene el mapa: por qué existen esas tareas, qué decisión alimentan y qué resultado debe volver al plan del producto.
Pensarlo como product manager no significa que sustituya al cargo. Significa usarlo para las partes mecánicas de la coordinación: mantener lista de riesgos, comprobar dependencias, preparar documentos, abrir tareas y traer decisiones pendientes. La estrategia, la responsabilidad frente al negocio y los juicios sobre personas siguen siendo humanos.
Empieza con una responsabilidad, no con un prompt gigante
Una responsabilidad útil tiene cinco piezas.
Resultado. Qué debe mantenerse verdadero, por ejemplo “el lanzamiento conserva una fecha realista y cada bloqueo tiene dueño”.
Fuentes. Qué documentos, canales, repositorios o tableros representan la realidad.
Cadencia. Cuándo revisar cambios y qué eventos justifican despertar.
Escalamiento. Qué decisiones debe traer y qué información puede actualizar sin interrumpir.
Límites. Qué acciones sólo puede preparar, cuáles requieren aprobación y cuáles no debe realizar.
Un ejemplo completo sería: “Mantén el lanzamiento de la versión móvil al día. Usa el plan, los issues del repositorio y el canal de QA. Avísame sólo si una fecha está en riesgo, falta un dueño o una decisión bloquea más de un día. Puedes actualizar el checklist y crear borradores; no envíes mensajes externos ni cambies producción sin mi aprobación”.
Esa instrucción es más pequeña que una especificación total, pero contiene el contrato que permite decidir los siguientes pasos.
Convierte objetivos amplios en resultados verificables
“Haz crecer el producto” es demasiado amplio incluso para un orquestador. Conserva la ambición, pero divídela en resultados que puedan comprobarse. Por ejemplo: entender la activación, reducir el tiempo hasta el primer valor, eliminar tres bloqueos del onboarding y preparar un experimento con criterio de éxito.
Cada resultado puede vivir en una tarea distinta. El dot mantiene las dependencias y la prioridad. Para trabajo de Codex que requiere varias iteraciones, un Goal añade un contrato persistente dentro de ese hilo. La documentación de OpenAI define un Goal como un objetivo asociado al hilo, con condición de término, restricciones, presupuesto y verificación por evidencia.
La frontera es importante. El dot puede coordinar una responsabilidad que abarca marketing, datos y desarrollo. Un Goal de Codex pertenece al hilo donde viven los archivos, comandos y pruebas de una parte técnica. No conviertas un objetivo de negocio en un bucle infinito de código. Define qué estado final demostrará el avance y cuándo debe volver al dot.
Cuándo abrir un hilo nuevo y cuándo continuar uno existente
Abre un hilo nuevo cuando cambia el artefacto, el entorno, el responsable o el criterio de término. Una investigación de usuarios y una corrección del checkout producen evidencia distinta y merecen conversaciones separadas. Continúa un hilo cuando el nuevo pedido depende de decisiones, archivos o resultados que ya están allí.
Un hilo delegado recibe instrucciones y contexto para ese trabajo, pero no hereda automáticamente cada conversación que tuviste con el dot. Por eso el mensaje de delegación debe incluir el objetivo, las fuentes, las restricciones, la salida esperada y la forma de comprobarla.
Evita abrir hilos para cada microtarea. El exceso fragmenta contexto y obliga a reconstruir decisiones. Una regla práctica es abrir un hilo por resultado auditable. Dentro de ese hilo, el agente puede ejecutar varios pasos mientras el criterio de término siga siendo el mismo.
Cómo orquestar varios hilos sin perder el control
Usa la conversación del dot como mesa de control y cada hilo como unidad de ejecución. La mesa de control conserva una lista pequeña: objetivo, tarea, estado, último hallazgo, próxima decisión y enlace al hilo. No copies todos los mensajes; conserva el dato que cambia el plan.
Ejecuta en paralelo sólo tareas independientes. La investigación de competidores, la revisión de accesibilidad y el análisis de eventos pueden avanzar al mismo tiempo. La implementación del experimento debe esperar a que exista una decisión de alcance.
Pide al dot que te informe por excepción. El progreso rutinario puede quedar en la actividad; una fecha en riesgo, un permiso faltante o dos fuentes contradictorias merecen notificación. OpenAI permite revisar las tareas que el dot inició desde Activity y dar instrucciones directas. El dot también puede comprobar resultados y enviar seguimientos.
Cierra el ciclo con una revisión del estado final. Que un hilo diga “completado” no prueba que el resultado se entregó. Abre el artefacto, ejecuta la prueba o inspecciona el sistema externo antes de actualizar el plan principal.
Memoria no significa acceso ilimitado a todas tus conversaciones
El dot usa la conversación actual, memoria relevante de ChatGPT y notas propias sobre preferencias, decisiones y responsabilidades. Esas notas no son una transcripción completa. Los mensajes visibles en ChatGPT, Slack o Teams permanecen en sus canales; cambiar de canal no crea otro dot, pero tampoco copia todo el historial en cada lugar.
Un nuevo hilo recibe el contexto que el dot le proporciona. Conectar un computador no concede acceso a todas las conversaciones ni hereda las sesiones del navegador personal. El computador cloud del dot tiene archivos y sesiones propios. Un entorno de Codex también debe configurarse con el repositorio y la preparación que necesita.
Para un product manager, esto conduce a una práctica concreta: documentar decisiones críticas en un artefacto compartido y pasar un resumen explícito a cada tarea. No uses “ya lo hablamos” como dependencia invisible. Si una restricción afecta precio, privacidad o alcance, escríbela en la fuente canónica.
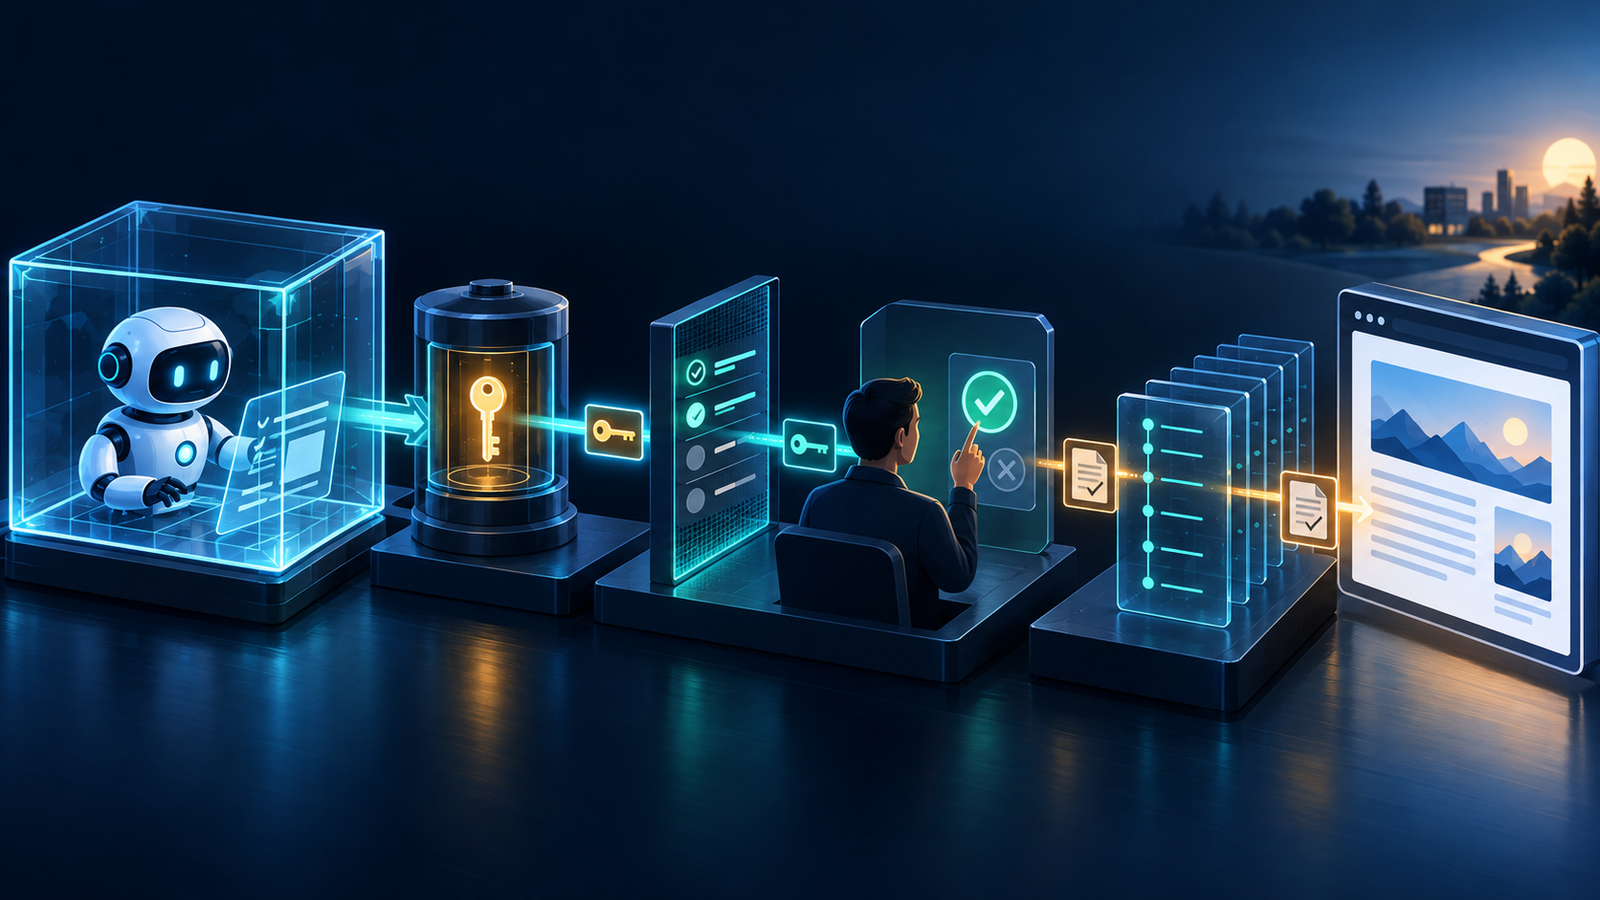
Coordinar no equivale a autorizar
Las conexiones están separadas. Un canal de mensajería permite hablar con el dot, pero no conecta automáticamente el correo, un plugin o el computador. Cada aplicación conserva sus permisos. Las acciones que afectan cuentas o comparten información pasan por una revisión que puede permitir, pedir aprobación o devolver el paso a la persona.
Las reglas personalizadas pueden definir comportamientos como actuar sin preguntar, actuar cuando se lo indiques, preguntar antes o entregarte la acción. Sirven para fijar límites recurrentes, pero no conceden acceso a una aplicación ni eliminan requisitos de seguridad.
Diseña por impacto. Leer un tablero puede ser continuo. Preparar un borrador puede no requerir interrupción. Enviar un correo a clientes, borrar archivos compartidos, mover dinero o publicar en WordPress necesita un alcance explícito. Un buen orquestador reduce preguntas rutinarias y aumenta la calidad de las preguntas importantes.
Ejemplo: coordinar un lanzamiento de producto
Objetivo principal: liberar una nueva activación móvil con métricas y plan de reversa.
Hilo 1, investigación: comparar cinco sesiones de usuario y entregar los tres puntos de abandono con evidencia. Hilo 2, producto: convertir esos hallazgos en un alcance de versión, criterios de aceptación y preguntas abiertas. Hilo 3, Codex: implementar el flujo aprobado, ejecutar pruebas y preparar un diff revisable. Hilo 4, calidad: revisar accesibilidad, estados de error y telemetría con un checklist. Hilo 5, lanzamiento: preparar notas, plan de reversa, responsables y comunicación, sin enviar nada.
El dot puede abrir o continuar esos hilos, seguir sus estados y resumir dependencias. Si la investigación cambia el alcance, detiene la implementación antes de desperdiciar trabajo. Si calidad encuentra un bloqueo, actualiza el riesgo y solicita una decisión. Cuando todos los criterios se cumplen, prepara el paquete de lanzamiento. La acción final sigue su control correspondiente.
El valor no está en tener cinco chats. Está en que cada uno entrega una evidencia al mismo objetivo y existe una instancia que sabe cuándo unirlos.
Configúralo como un sistema operativo de producto
1. Elige una sola responsabilidad que ya revisas cada semana. 2. Conecta únicamente las fuentes necesarias y comprueba sus permisos. 3. Define resultados, excepciones y acciones que requieren aprobación. 4. Decide qué información vivirá en una fuente canónica. 5. Pide un inventario inicial de tareas, riesgos y decisiones pendientes. 6. Delega un resultado por hilo y exige criterio de término. 7. Usa Activity para revisar trabajo y Scheduled para la cadencia fija. 8. Configura notificaciones por cambio importante, no por cada avance. 9. Revisa los primeros resultados y corrige instrucciones antes de ampliar el alcance. 10. Audita periódicamente tareas activas, reglas, conexiones y permisos.
Empieza con coordinación de sólo lectura y borradores. Añade acciones externas cuando el proceso ya demuestra que distingue estado, autorización y evidencia. Un dot puede sostener objetivos grandes, pero su mejor diseño no es “total libertad”. Es una responsabilidad clara, herramientas adecuadas y una ruta corta para pedir tu juicio cuando realmente importa.
Un artículo puede verse terminado y todavía no estar listo. Puede tener un título seguro, subtítulos ordenados y una conclusión optimista, pero no ayudar a decidir nada. AI slop es una etiqueta informal para ese resultado de apariencia convincente y utilidad débil. No significa que todo contenido hecho con IA sea basura ni que un texto humano sea automáticamente bueno.
La revisión debe separar tres preguntas. ¿La afirmación es verdadera y está respaldada? ¿La explicación ayuda al lector a actuar? ¿La pieza aporta algo reconocible en lugar de recombinar frases disponibles? Una respuesta negativa en cualquiera de esas capas exige corregir o retirar el pasaje.
Por eso Anti AI Slop no es un detector de estilo. Es una puerta de control editorial. El equipo registra lo que afirma, cómo lo sabe, quién lo revisó y qué versión exacta puede publicarse. La IA puede investigar, estructurar y proponer. La responsabilidad de publicar sigue siendo humana y organizacional.
Qué demuestra Antislop y qué no demuestra
El trabajo Antislop presentado en ICLR 2026 estudia patrones estilísticos repetitivos en modelos de lenguaje. Su propuesta combina un sampler que puede retroceder cuando detecta una expresión no deseada con un proceso de ajuste llamado Feature-level Training-time Preference Optimization. En sus evaluaciones, los autores informan una reducción de hasta 90 % en los patrones de slop estudiados sin una caída apreciable de capacidades generales.
El alcance importa. Ese 90 % no significa que el sistema elimine 90 % de las falsedades, que mejore cualquier texto en la misma proporción ni que detecte toda forma de contenido mediocre. Mide la reducción de rasgos definidos dentro de un conjunto de evaluación. La investigación aporta mecanismos útiles para controlar hábitos de generación, no una garantía universal de verdad o calidad.
La lección editorial es concreta: un filtro puede reducir patrones conocidos, pero no inventa una tesis, no verifica una fuente y no conoce el costo de publicar un error. Sirve como una barrera dentro de un sistema mayor.
La coherencia también se audita
Una fuente puede existir y aun así estar mal usada. SciSlop, un trabajo preliminar publicado en arXiv en octubre de 2026, analiza 390 pares de artículos científicos y sus registros de revisión. Su propuesta, SciSlopHarness, relaciona cambios del texto con comentarios y decisiones de revisión para estudiar señales de slop con contexto.
No corresponde extrapolar sus resultados a todo internet. Sí permite rescatar una idea operativa: evaluar una afirmación aislada no basta. Hay que comprobar si la fuente respalda exactamente lo que se escribió, si el alcance se conservó y si una corrección resolvió la objeción original.
En una redacción, eso se traduce en un registro de afirmaciones. Cada claim crítico conserva su fuente, fecha de consulta, fragmento o dato pertinente, nivel de certeza y estado de revisión. Cuando el texto cambia, la evidencia se vuelve a contrastar. La bibliografía deja de ser decoración al final del artículo y pasa a ser parte del control de calidad.
Cómo leer una cifra sin deformarla
LinkedIn informó en septiembre de 2026 que había reducido en 40 % las visualizaciones de contenido clasificado por sus sistemas como AI slop. La noticia no dice que todo contenido asistido por IA perdiera 40 % de alcance. Tampoco demuestra que usar una herramienta específica provoque una penalización automática.
La versión responsable conserva cuatro elementos: quién midió, qué clasificó, cuál fue la métrica y en qué periodo se comunicó. La versión slop convierte un dato acotado en una amenaza universal porque el titular resulta más llamativo.
Este ejemplo muestra por qué la exactitud editorial no consiste sólo en enlazar una URL. El claim debe mantener el significado de la fuente. Si el título afirma más que el documento citado, la presencia del enlace no corrige el problema.
Empieza por la decisión, no por el prompt
Antes de pedir un borrador, define la decisión que la pieza debe habilitar. Un lector puede necesitar elegir una política editorial, diseñar una revisión o decidir si un resultado es publicable. Ese objetivo determina qué evidencia hace falta y qué información sobra.
El registro mínimo de una afirmación contiene: identificador, texto normalizado, sección, tipo de claim, fuente primaria, fecha de consulta, alcance, responsable y estado. Los estados pueden ser PROPUESTO, RESPALDADO, CUESTIONADO o RETIRADO. Una cifra sin denominador o una recomendación sin contexto no avanza por entusiasmo.
Este registro también expone dónde la IA está infiriendo. La inferencia puede ser valiosa, pero debe presentarse como interpretación y no como una frase atribuida a la fuente. Separar dato, inferencia y opinión reduce el error sin volver ilegible el artículo.
Un flujo Anti AI Slop en siete pasos
1. Escribe un brief con lector, decisión, contribución original y riesgo de daño. 2. Crea el registro de claims antes del primer borrador. 3. Prioriza fuentes primarias y anota la fecha de consulta. 4. Redacta en borrador y marca las inferencias con claridad. 5. Ejecuta controles deterministas: enlaces, fechas, nombres, cifras, metadatos y estructura. 6. Usa evaluadores de modelo para criterios semánticos, con ejemplos de aprobación y rechazo. 7. Entrega a una persona la revisión de utilidad, exactitud, tono y consecuencias. 8. Congela la versión, calcula su hash y aprueba ese paquete exacto. 9. Publica con una identidad técnica de alcance mínimo y verifica el resultado remoto.
Anthropic recomienda combinar evaluadores basados en código, modelos y personas según el tipo de conducta que se quiere medir. En investigación, sus ejemplos incluyen groundedness y calidad de las fuentes. La idea no es reemplazar al editor con otra respuesta de IA. Es asignar cada comprobación al mecanismo que puede observarla mejor.
Los roles también deben separarse. Investigar no requiere credenciales de WordPress. Aprobar no debería publicar. El publicador recibe un paquete ya aprobado, una autorización de un solo uso y el mínimo permiso necesario.
El aporte reconocible y la versión exacta
Google recomienda contenido creado principalmente para ayudar a personas y pregunta si la página ofrece información, investigación, análisis o experiencia original. Su orientación sobre IA no prohíbe la automatización. Advierte contra generar muchas páginas sin valor añadido y contra el abuso de contenido escalado.
La pregunta útil no es si el texto parece humano. Es si existe una razón para publicarlo. Una pieza puede resumir investigación, pero necesita una contribución reconocible: un método, una comparación, una decisión o una experiencia verificable. Sin ese aporte, cambiar el tono sólo disimula la ausencia de valor.
Cuando el paquete está listo, el equipo aprueba una versión exacta. Texto, enlaces, imágenes, etiquetas, extracto y metadatos forman parte de la promesa editorial. Si cualquiera cambia, cambia el hash y la aprobación anterior deja de cubrir el resultado. Esta regla evita que una corrección pequeña esconda una alteración importante.
La puerta de calidad antes de publicar
Una evaluación sirve sólo si distingue resultados buenos de malos. Construye un conjunto pequeño con artículos aceptables y errores sembrados: una cifra inflada, una fuente secundaria innecesaria, un enlace que no respalda el claim, una inferencia presentada como hecho y un párrafo correcto pero inútil.
Mide tres cosas. Cuántos errores reales detecta la puerta, cuántos pasajes válidos bloquea y cuánto tiempo agrega al flujo. Un evaluador que rechaza todo parece estricto, pero no ayuda. Uno que aprueba prosa fluida sin comprobar evidencia sólo automatiza la complacencia.
Revisa además la experiencia publicada: imágenes cargadas, textos alternativos, jerarquía de encabezados, enlaces, móvil, extracto, etiquetas y portada. No declares listo porque el proceso local terminó. La entrega existe cuando el resultado remoto coincide con la versión autorizada.
SEO y distribución sin fabricar volumen
La política de Google no convierte la asistencia de IA en una infracción automática. El riesgo aparece cuando la automatización se usa para manipular resultados, producir páginas a escala sin valor o imitar autoridad que no existe. Transparencia, autoría y método ayudan, pero no rescatan una pieza vacía.
La distribución también debe partir de la versión aprobada. Un carrusel, un correo o una publicación en LinkedIn puede resumir el artículo, pero no exagerar sus conclusiones. La cifra del 40 %, por ejemplo, debe conservar su sujeto y su contexto aunque el formato sea breve.
Publicar menos puede ser una ventaja. Tres piezas con evidencia, imágenes pertinentes y una posición editorial clara construyen más confianza que treinta variaciones de la misma lista de consejos.
Un piloto Anti AI Slop para Doctrina Digital
Empieza con una sola pieza. Define el brief y los claims críticos. Asocia cada claim con una fuente primaria y registra las inferencias. Prepara portada, imágenes internas, extracto y etiquetas antes de congelar la versión. Después ejecuta una revisión editorial con ejemplos de error conocidos.
La aprobación debe nombrar la versión y el hash. La publicación usa una autorización de una sola vez, comprueba el estado remoto esperado y conserva evidencia del resultado. Si la respuesta de WordPress es ambigua, el flujo se detiene y reconcilia. No intenta de nuevo a ciegas, porque un reintento podría duplicar o sobrescribir una publicación que sí ocurrió.
Ese circuito no promete perfección. Hace algo más útil: convierte la calidad en un proceso observable, permite aprender de cada fallo y mantiene la velocidad sin entregar las llaves de producción al mismo agente que redacta.
Un chatbot responde. Un sistema agéntico puede observar un entorno, elegir una acción, usar una herramienta, comprobar el resultado y decidir el siguiente paso. La diferencia no está en una interfaz más llamativa, sino en el bucle que conecta lenguaje, estado y efectos reales.
Esa capacidad añade utilidad y riesgo al mismo tiempo. Cuando un modelo puede consultar una base de datos, abrir una tarea o publicar en un CMS, una frase ambigua deja de ser únicamente una mala respuesta: puede convertirse en una acción incorrecta. Por eso conviene dominar el vocabulario antes de conectar herramientas. Los siguientes 25 conceptos sirven para diseñar el sistema y también para revisarlo.
1 a 5: qué decide y qué debe lograr
1. Sistema agéntico. Es la combinación de modelo, instrucciones, herramientas, estado y reglas de ejecución que permite elegir pasos según lo que ocurre. No es sinónimo de autonomía ilimitada.
2. Workflow determinista. Es un recorrido fijado en código: primero A, después B y, si falla, C. Puede incluir modelos, pero el modelo no decide libremente la arquitectura. Es preferible cuando el proceso es estable y el costo de improvisar es alto.
3. Modelo. Es el componente que interpreta el contexto y propone respuestas o acciones. No conoce por sí solo el estado actual de tu negocio ni obtiene permisos mágicos: recibe lo que el sistema le entrega.
4. Instrucciones. Definen el papel, los límites y las prioridades del agente. Una instrucción útil especifica qué puede hacer, qué no puede hacer, qué fuentes son válidas y cuándo debe detenerse.
5. Objetivo. Describe el resultado que debe quedar verdadero, no sólo la próxima actividad. “Revisar el lanzamiento” es vago. “Identificar bloqueos, asignar dueño y entregar una lista validada antes de las 16:00” tiene una condición observable.
6 a 10: cómo conserva contexto sin inventar memoria
6. Criterio de término. Es la prueba que permite afirmar que el objetivo terminó. Puede ser un test verde, un registro creado, un documento aprobado o una verificación remota. Sin este criterio, el agente puede confundir actividad con avance.
7. Contexto. Es la información disponible en una interacción: mensajes, documentos, resultados de herramientas e instrucciones. Es una selección, no una copia perfecta de todo lo que alguna vez ocurrió.
8. Estado. Son los datos duraderos que describen dónde está el proceso: borrador, aprobado, programado, bloqueado. El estado importante debe vivir en un sistema canónico y no depender de que el modelo “recuerde”.
9. Memoria. Es información recuperable entre conversaciones, como preferencias o decisiones anteriores. Ayuda a mantener continuidad, pero no sustituye un registro transaccional ni debe usarse como prueba de que una acción ocurrió.
10. Sesión. Agrupa una ejecución o una conversación con su historial operativo. Una sesión permite continuar el trabajo, limitar cuánto contexto se recupera y separar tareas que no deberían contaminarse entre sí.
11 a 15: herramientas, MCP y superficies de acción
11. Herramienta. Es una función que el agente puede invocar para leer o cambiar un sistema. Su contrato debe decir qué recibe, qué devuelve y qué efecto produce. “Gestionar WordPress” es demasiado amplio; “crear un borrador sin publicarlo” es auditable.
12. Llamada de herramienta. Es una invocación concreta con argumentos concretos. Debe validarse antes de ejecutar y registrar un resultado estructurado. Una herramienta segura rechaza parámetros inesperados en vez de adivinarlos.
13. MCP. Model Context Protocol estandariza la conexión entre clientes y servidores que ofrecen contexto o capacidades. Conectar un servidor MCP no vuelve segura una integración. La identidad, la autorización y los límites siguen siendo responsabilidad del despliegue.
14. Recurso. En MCP, un recurso entrega datos o contenido que la aplicación puede incorporar al contexto. Leer un documento y modificarlo son operaciones distintas; esa separación ayuda a ofrecer acceso de sólo lectura cuando basta.
15. Prompt reutilizable. En MCP, un prompt puede representar una plantilla seleccionada por la persona usuaria. No equivale a una herramienta con efectos. Diferenciar instrucciones, recursos y acciones evita que una comodidad de interfaz se transforme en permiso de escritura.
16 a 20: delegación y orquestación
16. Orquestador. Es el componente que divide el trabajo, elige especialistas y reúne resultados. Puede ser código, un modelo o una mezcla. Su responsabilidad no es hacer todo, sino conservar el objetivo y resolver dependencias.
17. Agente especialista. Tiene instrucciones y herramientas acotadas para una tarea, como investigar fuentes, revisar seguridad o editar estilo. La especialización reduce contexto irrelevante y permite permisos distintos por función.
18. Handoff. Transfiere el control de la conversación o ejecución a otro agente. El especialista pasa a ser el actor activo. Conviene cuando el nuevo papel debe responder directamente y asumir la siguiente etapa.
19. Agente como herramienta. El orquestador consulta a un especialista, recibe su resultado y conserva el control. Es útil cuando una sola voz debe combinar varias contribuciones y responder por el resultado final.
20. Paralelización. Ejecuta tareas independientes al mismo tiempo. Acelera investigación o revisión, pero no resuelve dependencias. Si tres agentes editan el mismo artefacto sin una estrategia de integración, sólo producen tres conflictos más rápido.
21 a 25: control, seguridad y evidencia
21. Bucle agéntico. Es la secuencia observar, decidir, actuar y comprobar. Debe tener límites de iteraciones, tiempo o presupuesto. Un bucle sin condición de salida no es más autónomo: es menos gobernable.
22. Guardrail. Es una validación que acepta, modifica o bloquea entradas, salidas o llamadas de herramienta. Los controles que protegen una escritura deben ejecutarse antes del efecto, no sólo revisar el texto final.
23. Aprobación humana. Es un punto explícito donde una persona autoriza una acción de mayor impacto. La aprobación debe mostrar el objeto exacto, su versión, el alcance y la vigencia. “Haz lo necesario” no sirve como permiso permanente para todo.
24. Mínimo privilegio. Cada agente y credencial recibe sólo las capacidades requeridas para su función. El investigador puede leer fuentes; el editor crea versiones; el publicador conserva la única credencial de WordPress y sólo aparece durante una liberación controlada.
25. Observabilidad y evaluación. Una traza registra pasos, herramientas, handoffs y errores. Una evaluación compara el resultado con criterios. La traza explica qué pasó; la evaluación decide si estuvo bien. Ambas deben excluir secretos y datos innecesarios.
Dos controles que convierten el vocabulario en operación
La idempotencia evita repetir un efecto cuando llega dos veces la misma solicitud. Una clave estable permite reconocer que “publicar este paquete” ya fue procesado. No basta con pedirle al modelo que tenga cuidado: el receptor debe imponer la unicidad.
La reconciliación resuelve la escritura ambigua. Si una conexión se corta después de enviar una orden, el sistema no sabe todavía si el destino la aplicó. El estado correcto es “reconciliando”: inspeccionar el remoto, comparar identificadores y decidir con evidencia. Reintentar a ciegas puede duplicar publicaciones, pagos o mensajes.
Estos controles parecen detalles de backend, pero son parte del diseño agéntico. La autonomía útil no consiste en hacer más llamadas. Consiste en avanzar sin perder la posibilidad de demostrar qué ocurrió.
Ejemplo: conectar un agente con WordPress sin entregarle el sitio
WordPress aparecía en el 40,1% de los sitios medidos por W3Techs el 12 de octubre de 2026. Esa escala convierte cualquier integración editorial en una superficie que merece límites claros. No hace falta afirmar que WordPress es “el más atacado” para reconocer el riesgo: una credencial con demasiados permisos y una herramienta genérica amplían el impacto de un error.
Un patrón prudente separa seis responsabilidades. Primero, PostgreSQL conserva el artículo canónico, su versión y sus evidencias. Segundo, el agente investigador sólo lee fuentes. Tercero, el editor crea una versión nueva y no publica. Cuarto, una persona aprueba el hash exacto. Quinto, un publicador aislado recibe una contraseña de aplicación revocable y una autorización de un solo uso. Sexto, una lectura posterior confirma título, URL, fecha y medios antes de declarar el resultado verificado.
Las contraseñas de aplicación de WordPress están diseñadas para integraciones y pueden revocarse de manera individual. Eso es mejor que compartir la contraseña principal, pero no reemplaza el mínimo privilegio. La cuenta técnica debe tener un rol reducido, usar HTTPS y mantenerse fuera de los agentes que no publican. Si una herramienta MCP ofrece crear, editar, borrar y administrar plugins con la misma credencial, el problema no es MCP: es el contrato excesivo que se decidió exponer.
Una lista corta antes de llamar “agente” a tu sistema
1. Escribe el objetivo y una prueba de término. 2. Decide qué estado es canónico y dónde se persiste. 3. Separa lectura, edición, aprobación y publicación. 4. Diseña herramientas pequeñas con esquemas estrictos. 5. Asigna una identidad y permisos mínimos a cada función. 6. Coloca guardrails antes de los efectos externos. 7. Añade idempotencia para repeticiones y reconciliación para incertidumbre. 8. Registra trazas sin secretos y evalúa el estado final, no la elocuencia del agente. 9. Define cuándo intervenirá una persona. 10. Empieza con un workflow simple y añade autonomía sólo donde cambie el camino de forma legítima.
Con este vocabulario, la conversación deja de ser “cuánta libertad darle a la IA” y pasa a preguntas que sí se pueden responder: qué objetivo tiene, qué puede observar, qué puede modificar, quién aprueba y qué evidencia demostrará que terminó.
Define el resultado antes de elegir la herramienta
Una automatización comercial útil empieza con una definición sencilla: qué evento inicia el proceso, qué datos necesita el equipo, qué sistema conserva el registro y qué acción confirma que el flujo terminó. Si esas cuatro decisiones no están claras, conectar aplicaciones sólo acelera un proceso confuso.
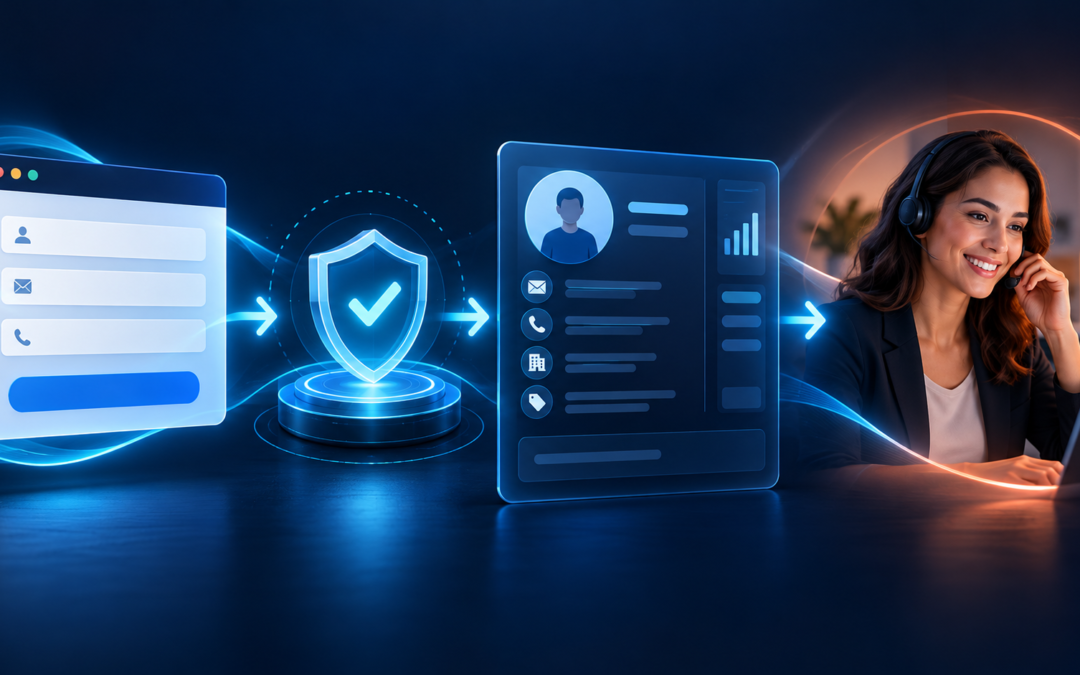
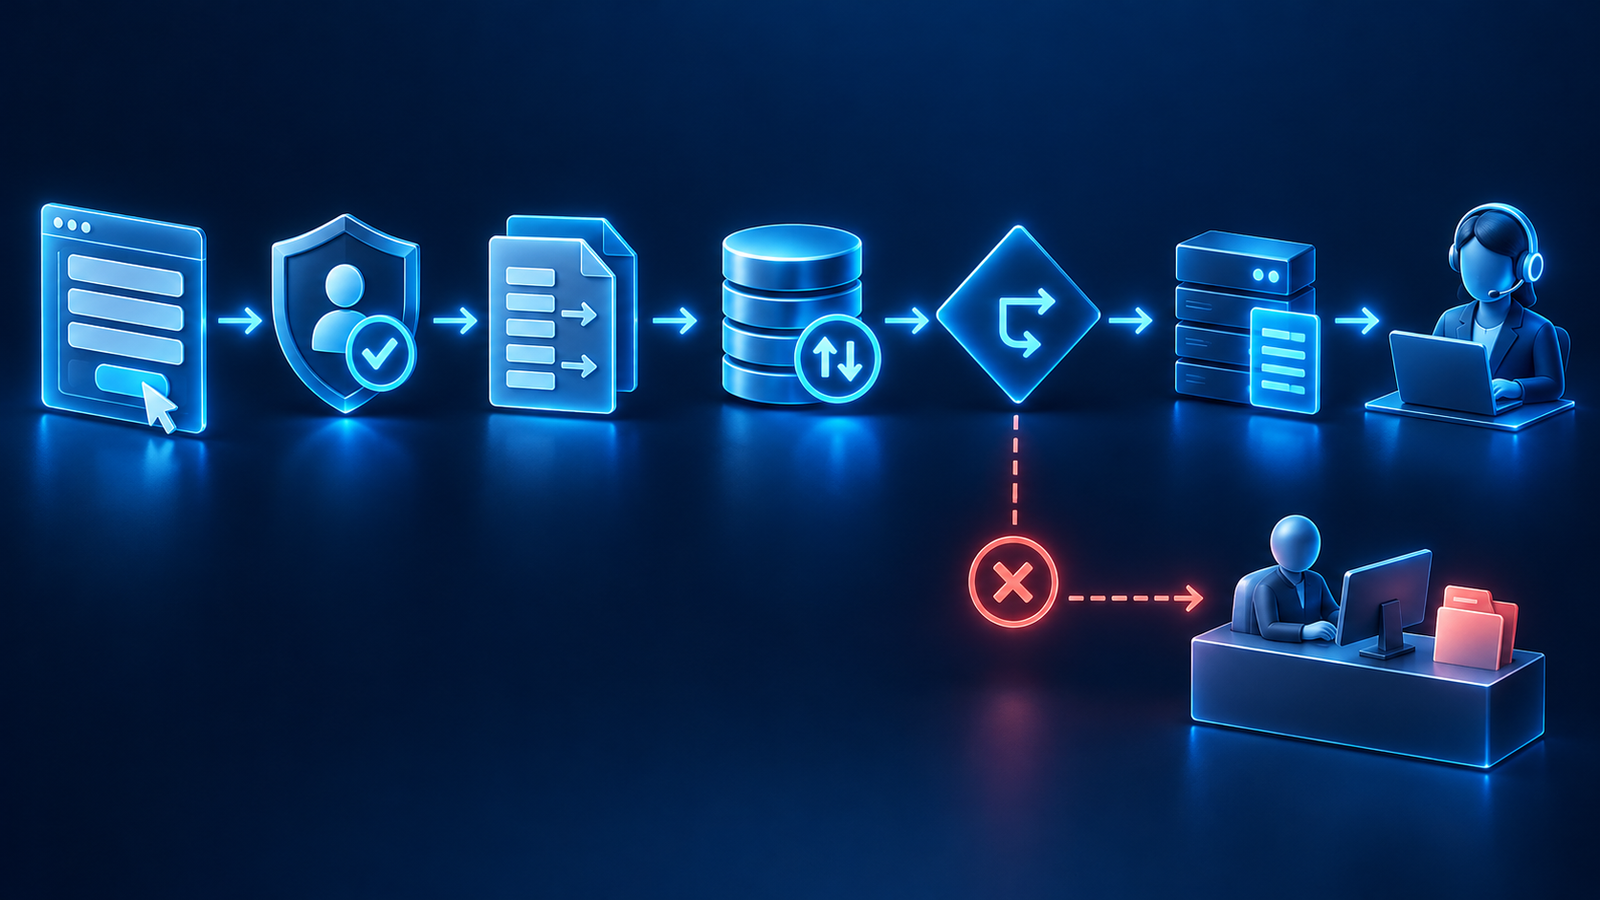
En este ejemplo, una persona completa un formulario para solicitar una conversación comercial. El flujo valida los campos, busca o actualiza el contacto en el CRM, aplica una regla de prioridad y deja una tarea para el equipo. La persona recibe una confirmación después de que el CRM acepta el registro.
Antes de construir, anota los campos mínimos. Un conjunto razonable incluye correo, nombre, empresa, necesidad, fecha objetivo y autorización de contacto. No pidas datos que el proceso no usa. También define qué sistema será la fuente principal. En este caso es el CRM, no la planilla del formulario ni el historial del automatizador.
El flujo completo, paso por paso
1. El formulario envía un evento por HTTPS al webhook. 2. El flujo rechaza solicitudes sin autenticación o con un formato inesperado. 3. Una etapa de normalización elimina espacios accidentales, unifica nombres de campos y valida los obligatorios. 4. El CRM crea o actualiza el contacto usando una clave estable, como el correo. 5. Una regla explícita asigna el siguiente paso. Puede ser revisión manual, seguimiento comercial o cierre sin contacto. 6. El sistema registra el resultado antes de enviar una notificación o un correo. 7. Si algo falla, una ruta de error conserva el identificador de la ejecución y avisa al responsable sin incluir el formulario completo en el mensaje.
El orden importa. Si envías el correo antes de confirmar la escritura en el CRM, puedes prometer un seguimiento que el equipo nunca verá. Si repites todo el flujo después de un timeout, puedes crear tareas o correos duplicados. El registro duradero debe preceder a los efectos secundarios.
Ejemplo con n8n y HubSpot
En n8n, crea un Webhook con método POST. Usa la URL de prueba mientras construyes y cambia a la URL de producción sólo cuando el workflow esté publicado. Protege el endpoint con el método de autenticación que soporte el emisor. n8n admite autenticación Basic, por cabecera y JWT, además de una lista de direcciones IP como control adicional.
Después del webhook, agrega una etapa que prepare un objeto estable. Conserva únicamente los campos previstos y añade un identificador del evento. Una condición separa las solicitudes completas de las incompletas. Para una entrada que no cumple el contrato, el nodo Stop And Error puede terminar la ejecución con un error legible y activar el flujo de manejo de fallos.
Para HubSpot, el endpoint de upsert permite crear o actualizar registros identificados por una propiedad única. En un flujo de contactos, el correo puede cumplir esa función cuando corresponde a la política de datos del negocio. La solicitud lleva el token en la cabecera Authorization y sólo las propiedades que el CRM necesita. Configura la aplicación con el alcance mínimo de escritura para contactos y guarda el token en el almacén de credenciales, nunca dentro de un nodo de código o un mensaje de error.
La regla de prioridad debe ser visible y fácil de cambiar. Un ejemplo podría marcar como revisión manual toda solicitud incompleta, enviar a seguimiento las solicitudes completas con autorización de contacto y cerrar las que piden no ser contactadas. Esta regla ilustra el mecanismo, no una recomendación universal. El equipo debe reemplazarla por criterios propios y revisar si produce resultados injustos o inútiles.
Evita que un reintento duplique el trabajo
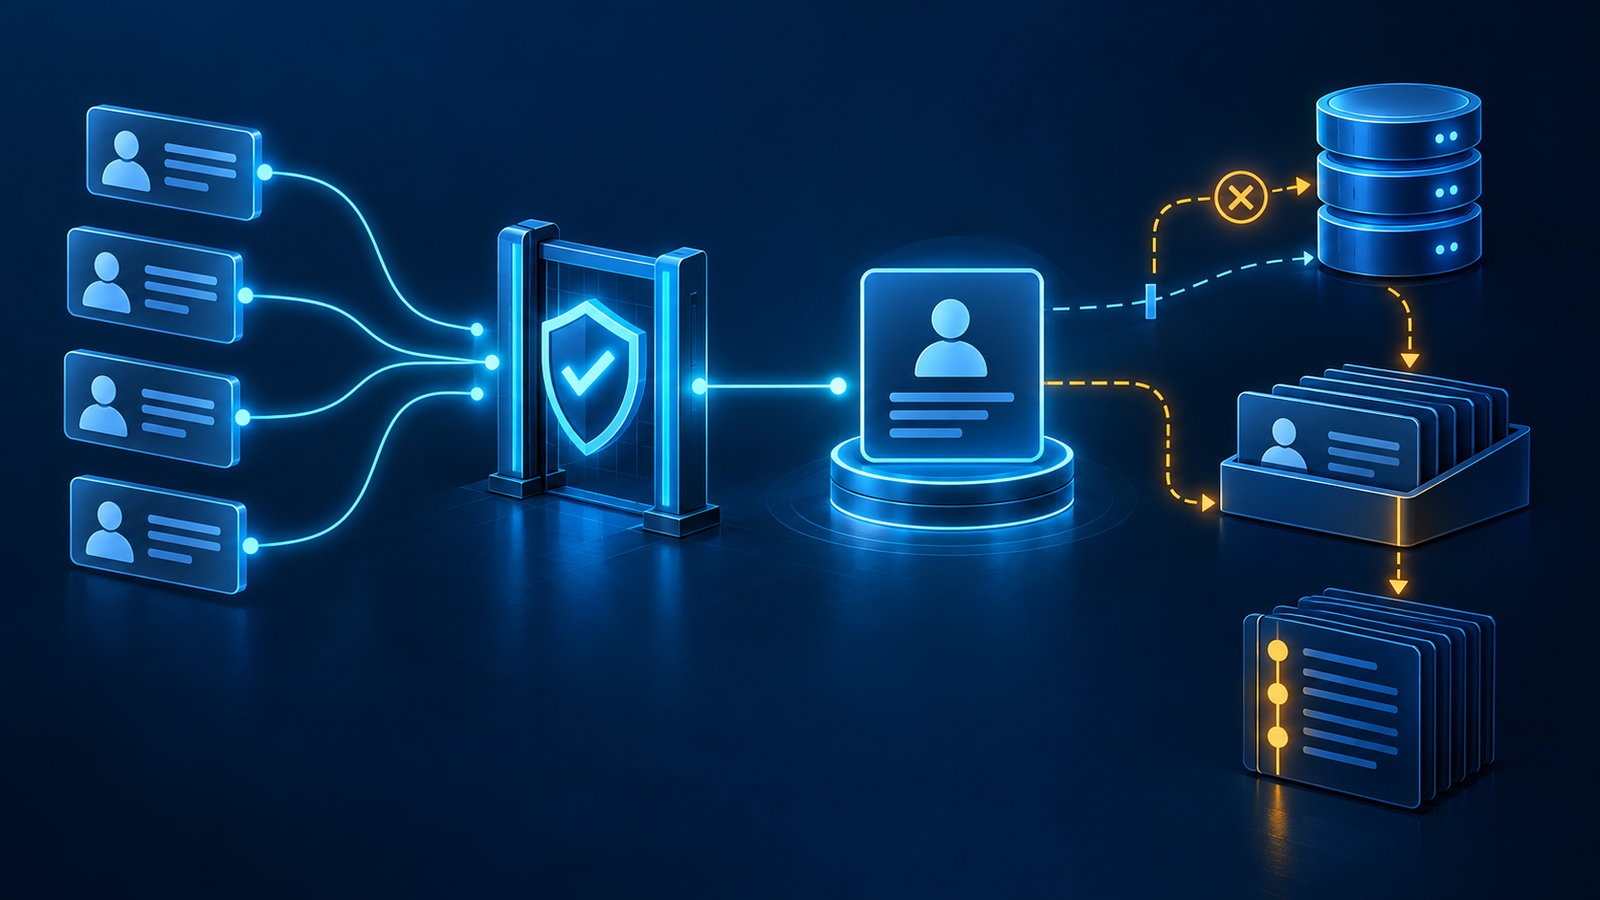
Los webhooks y las APIs pueden entregar o procesar un evento más de una vez. Por eso, el flujo necesita una clave de idempotencia. Si el formulario entrega un identificador estable, guárdalo junto con el estado del proceso. Si no lo entrega, genera una clave a partir de datos que representen la misma solicitud y define durante cuánto tiempo será válida.
El upsert del CRM evita la carrera de crear primero y buscar después, pero no controla todos los efectos. Un contacto único no impide que el flujo genere dos tareas o envíe dos correos. Mantén un registro separado de los eventos procesados y consulta ese registro antes de cada efecto externo. Una repetición autenticada que ya terminó debe responder como procesada sin volver a ejecutar la acción.
También considera el caso más incómodo: el CRM recibió la solicitud, pero la conexión terminó antes de devolver una respuesta. No asumas que la escritura falló. Busca el contacto por la clave estable o manda el evento a una cola de reconciliación. Repetir a ciegas es la forma más rápida de convertir un fallo de red en un problema comercial.
Diseña la ruta de error antes de activar el flujo
n8n permite asignar un workflow de error a otro workflow. Ese flujo comienza con Error Trigger y recibe datos sobre la ejecución fallida, incluido el último nodo ejecutado cuando esa información existe. Úsalo para crear una alerta con el identificador de ejecución, el nombre del workflow, la etapa y una descripción breve.
No copies el cuerpo completo del formulario en el correo de alerta. Los datos personales, tokens y cabeceras de autenticación no pertenecen a los logs. Quien investiga el incidente debe abrir la ejecución con el acceso correspondiente.
Define qué errores admiten reintento. Un 429 o un fallo de red inequívocamente anterior a la escritura puede esperar y reintentarse con un límite. Un timeout después de enviar la escritura exige comprobación. Un error de validación necesita corregir datos o configuración, no cinco intentos idénticos. La pantalla de ejecuciones de n8n permite revisar estados y volver a ejecutar un fallo con la versión original o la versión corregida del workflow.
Prueba seis casos antes de usar datos reales
Usa direcciones y empresas ficticias en un entorno de prueba. Verifica estos casos por separado:
1. Una solicitud válida crea un contacto y una sola tarea. 2. El mismo identificador enviado dos veces no duplica tareas ni mensajes. 3. Una solicitud incompleta termina en revisión o error sin escribir datos parciales. 4. Una firma o credencial inválida no inicia el proceso. 5. Una respuesta 429 respeta la espera y el límite de reintentos. 6. Un timeout posterior a la solicitud queda pendiente de reconciliación en vez de repetirse.
Guarda para cada caso el identificador de ejecución, el estado final y la evidencia en el CRM. La prueba no termina cuando todos los nodos se ven verdes. Termina cuando el contacto, la tarea y la notificación coinciden con lo esperado y una segunda ejecución no cambia ese resultado.
Pasa a producción con una lista corta de controles
Antes de activar la URL de producción, confirma que el webhook usa HTTPS y autenticación, que el token del CRM tiene sólo los permisos necesarios y que los secretos están fuera del workflow exportado. Revisa el esquema de datos, el aviso de privacidad y el tiempo de conservación con la persona responsable del negocio.
Deja activa la ruta de error, asigna un responsable y define una pausa manual. Conserva una versión exportable del workflow y documenta la clave usada para detectar duplicados. Durante los primeros días, compara una muestra de formularios con el CRM y con las tareas creadas. Corrige la regla si está enviando solicitudes a la ruta equivocada.
El primer objetivo no es automatizar todo el ciclo comercial. Es demostrar que una solicitud entra una vez, queda registrada con contexto suficiente y llega a una persona que sabe qué hacer después. Cuando ese recorrido sea estable, añade nuevas ramas sin perder trazabilidad.
Mediante prácticas como la reflexión matutina y vespertina, la gratitud, y la atención plena, se puede alcanzar una tranquilidad y claridad mental en la era digital. Descubre como conseguir una relación consciente y equilibrada con la tecnología.
Fomentar una cultura de innovación y aprendizaje continuo es esencial para que las empresas se mantengan competitivas en el entorno actual. Al promover un ambiente de crecimiento constante, colaboración y creatividad, las organizaciones no solo aumentan la motivación y el compromiso de sus equipos, sino que también mejoran su capacidad de adaptación a los cambios del mercado. Desde talleres hasta plataformas de aprendizaje digital, cada esfuerzo por impulsar la innovación fortalece la cultura empresarial y prepara a las empresas para los desafíos futuros.
Descubre las principales tendencias digitales de 2025 que están transformando los negocios modernos. Desde IA y automatización hasta comercio social y sostenibilidad, este artículo revela cómo la tecnología está redefiniendo la forma de emprender, innovar y crecer en la era digital.
Una guía práctica para recibir un formulario, validar los datos, evitar duplicados, registrar el contacto en el CRM y activar un seguimiento que se pueda auditar.