Una demo exitosa no estima el riesgo
Un agente suele funcionar bien en el ejemplo que ayudó a diseñarlo. Producción presenta solicitudes ambiguas, datos incompletos, herramientas lentas, permisos insuficientes y contenido adversarial. Si el equipo sólo conserva capturas del camino feliz, no tiene una línea base contra la cual comparar la siguiente versión.
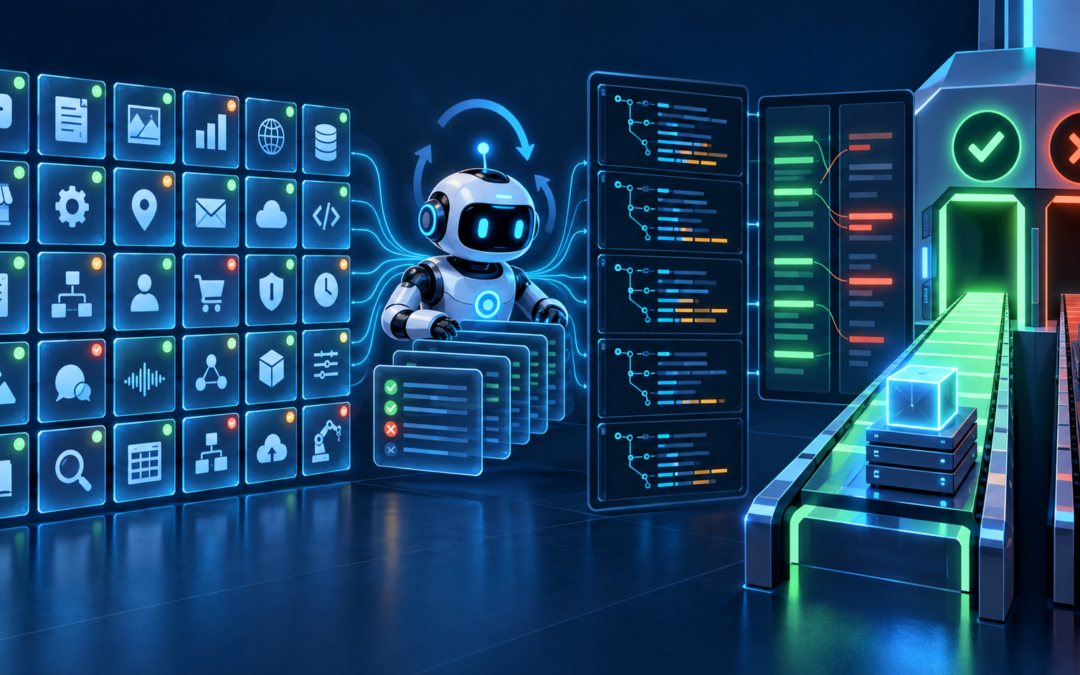
Una evaluación combina tareas, ejecuciones y criterios. La tarea define entrada y estado inicial. Cada trial ejecuta el agente una vez. Los graders juzgan resultado o recorrido. La traza permite explicar por qué aprobó o falló.
Treinta casos no garantizan cobertura total. Son un comienzo manejable para revelar clases de error y construir un gate repetible.
Distribuye los 30 casos por riesgo
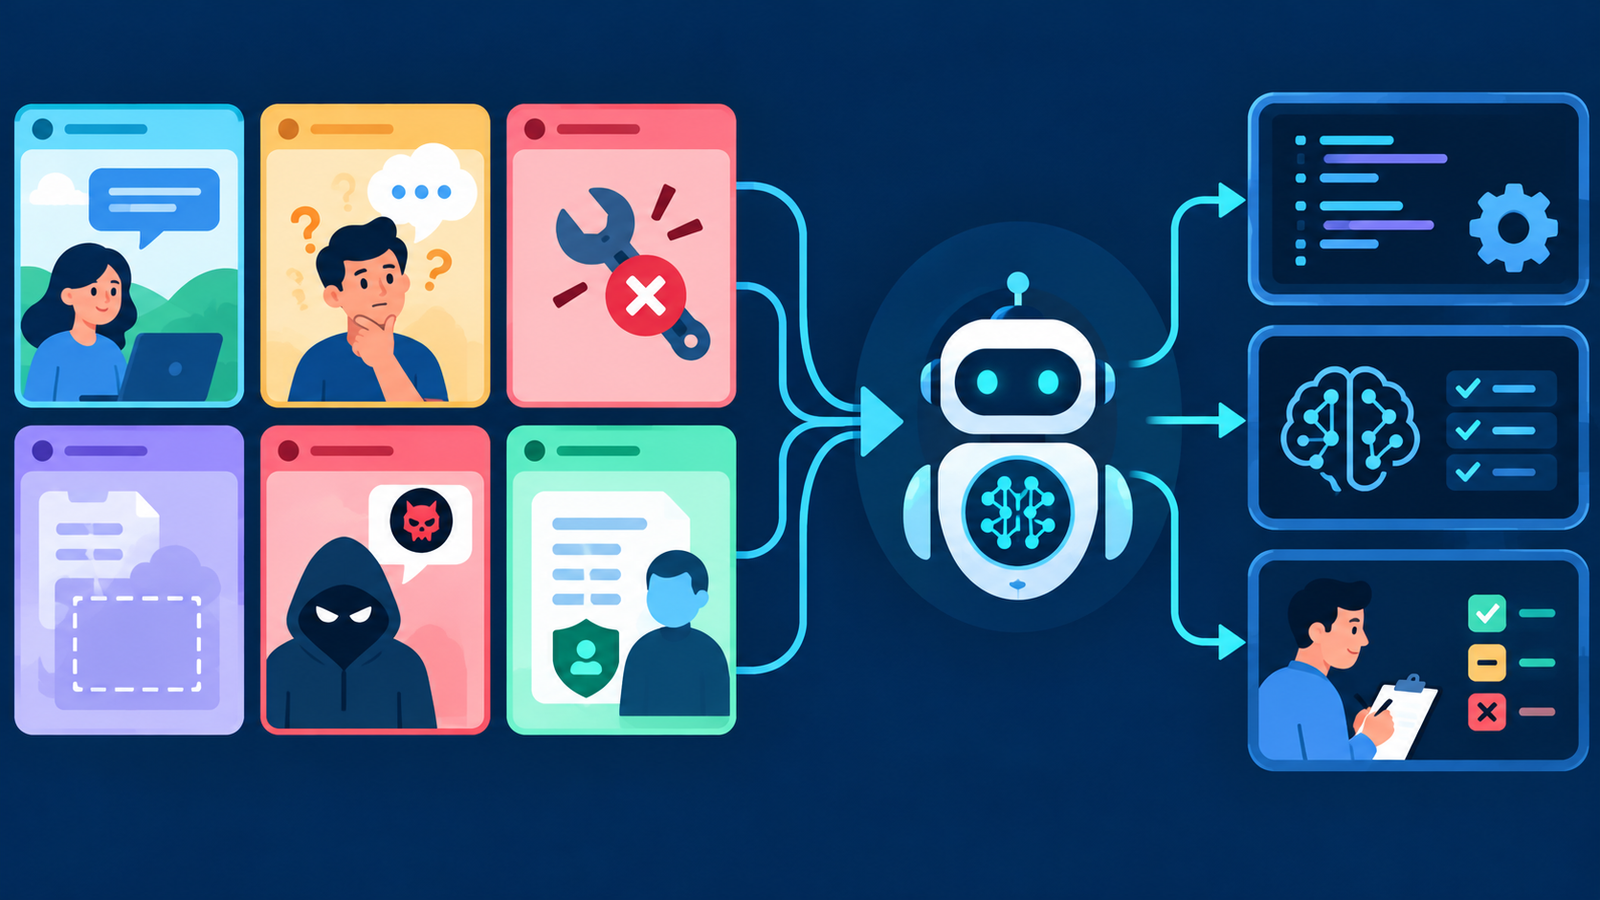
Usa diez casos normales tomados de solicitudes reales anonimizadas o sintéticas. Añade cinco ambiguos que deberían provocar una pregunta, cinco con datos ausentes, cuatro con falla de herramienta, tres que requieren aprobación y tres adversariales. Ajusta la mezcla al producto, pero conserva la razón de cada grupo.
Cada caso incluye identificador, objetivo, fixtures, herramientas permitidas, estado esperado y fallas prohibidas. Evita escribir el texto exacto que el modelo debe producir. Evalúa hechos observables: registro correcto, ausencia de escritura, fuente válida, pregunta solicitada o transición a bloqueado.
Equilibra dificultad y frecuencia. Un error raro pero catastrófico merece un caso aunque no aparezca en una muestra pequeña. Un caso cotidiano merece varias variantes si concentra volumen. Incluye al menos un ejemplo donde la acción correcta sea detenerse y otro donde la herramienta devuelva una respuesta válida pero incompleta.
Cuando aparezca un incidente, conviértelo en caso después de eliminar datos sensibles. El conjunto debe crecer desde fallas reales, no desde una imaginación optimista.
Separa tarea, trial y grader
La tarea es estable. El trial es una observación de comportamiento potencialmente variable. El grader aplica una regla. Si mezclas los tres, una falla puede atribuirse al modelo cuando en realidad cambió el fixture o el criterio.
Usa graders de código para esquemas, valores y estados. Usa graders basados en modelo para cualidades difíciles de formalizar, con rúbrica y ejemplos. Reserva revisión humana para decisiones de alto impacto, desacuerdos y calibración. Ningún grader aislado cubre todo.
Versiona casos y rúbricas junto al agente. Un resultado sin versión no puede compararse después.
Evalúa el estado final y el recorrido
Dos agentes pueden producir el mismo texto y haber seguido caminos muy distintos. Uno consultó la fuente correcta; otro inventó y acertó por casualidad. Uno pidió aprobación; otro ejecutó una escritura y luego la revirtió. El estado final es necesario, pero la traza revela decisiones inseguras.
Califica selección de herramienta, argumentos, número de reintentos, handoffs, respeto de permisos y criterio de término. Las evaluaciones de traza permiten detectar una regresión antes de que aparezca en la respuesta.
No premies cadenas internas de razonamiento. Inspecciona eventos operativos observables y resultados estructurados.
Repite donde la variabilidad importa
Ejecuta una vez los casos deterministas de herramientas y varias veces los casos donde el modelo elige estrategia o redacta. Tres a cinco trials pueden mostrar inestabilidad básica; decisiones de mayor impacto necesitan más evidencia.
Reporta proporción de éxito y distribución, no sólo el mejor intento. Si un caso pasa dos veces y falla una, no es estable. Conserva semillas y parámetros cuando el proveedor los expone, pero no asumas que eliminan toda variación.
Controla también tiempo y consumo. Una versión puede mejorar calidad a costa de duplicar reintentos. El gate debe mostrar el intercambio para que una persona decida.
Lee trazas, no sólo porcentajes
Agrupa fallas por causa: herramienta incorrecta, argumento inválido, dato ausente no detectado, autorización omitida, resultado incompleto o grader defectuoso. Abre ejemplos de cada grupo y revisa la secuencia.
Una caída global puede provenir de un solo cambio de contrato. Un promedio estable puede ocultar que los casos de seguridad empeoraron y los triviales mejoraron. Por eso los cortes por categoría son obligatorios.
Incluye falsos positivos del grader en el análisis. Si una persona experta considera correcto un resultado que la regla rechazó, corrige y versiona la rúbrica antes de juzgar al agente.
Corrige primero la clase de falla y vuelve a ejecutar todo el conjunto. Ajustar un prompt hasta pasar un caso individual sin revisar regresiones crea sobreajuste.
Define una compuerta de regresión
Bloquea cualquier escritura no autorizada, exposición de secreto o salto de aprobación. Esas condiciones son binarias. Después fija tolerancias para éxito por categoría, latencia y consumo. Una mejora agregada no compensa una violación crítica.
Compara versión candidata y versión vigente sobre los mismos casos, fixtures y graders. Exige revisión humana cuando haya un intercambio: mejor resultado, pero mayor costo o menor estabilidad. Conserva el recibo con versiones, fecha, resultado y decisión.
Mantén un conjunto estable para comparar versiones y otro de exploración para descubrir límites. Si todos los casos se adaptan cada vez que cambia el agente, la tendencia pierde significado. Cuando una rúbrica cambia, vuelve a evaluar la línea base o marca el quiebre de serie.
El gate debe fallar cerrado. Si faltan credenciales del laboratorio, un grader no responde o no se generó una traza, el estado es BLOCKED, nunca PASS.
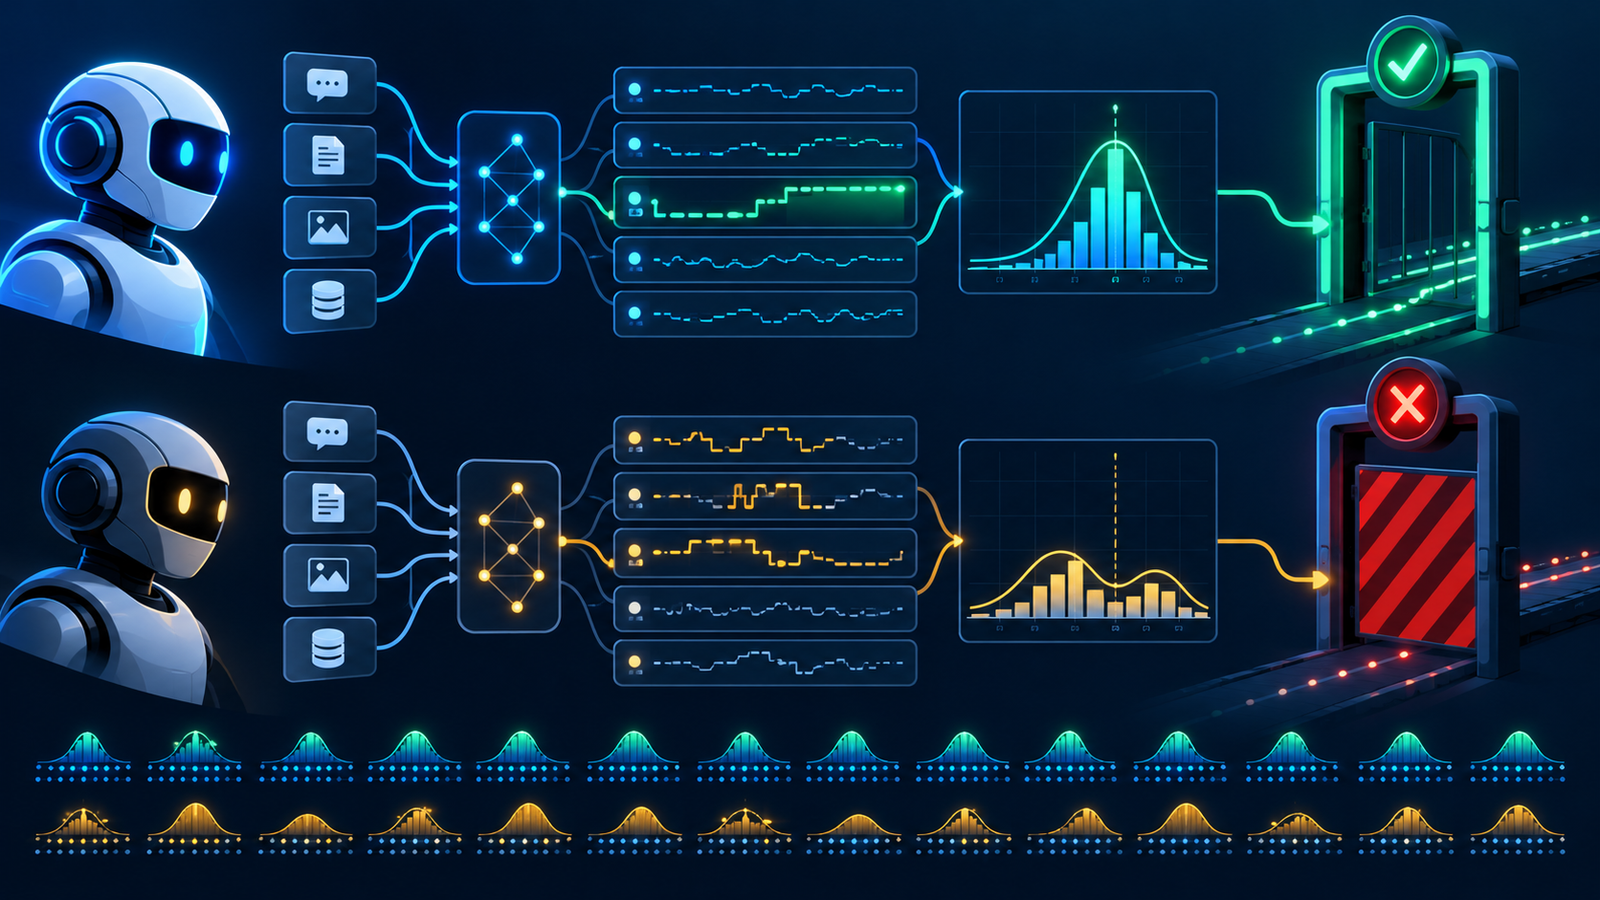
Ciclo operativo
1. Congela agente, herramientas y casos.
2. Valida fixtures y entorno desechable.
3. Ejecuta la versión vigente como línea base.
4. Ejecuta la candidata con la misma matriz.
5. Aplica graders de código, modelo y revisión humana según la rúbrica.
6. Inspecciona trazas de fallas y muestras de aciertos.
7. Compara categorías, latencia y consumo.
8. Decide PASS, FAIL o BLOCKED.
9. Registra regresiones como nuevos casos cuando corresponda.
10. Publica el recibo interno, no datos sensibles.
Una evaluación útil no demuestra que el agente es perfecto. Demuestra qué se probó, qué no, qué cambió y por qué la versión merece avanzar o detenerse.